
Préparation technique
Les robots d'IA peuvent-ils lire votre site ? Vérification technique en 10 minutes
Beaucoup de robots d'IA ne lisent que le HTML brut et respectent robots.txt. Vérifiez accès, noindex, rendu, codes HTTP, canonical, sitemap, vitesse et schema en 10 minutes.
 Par Nasir Ali Joiya, PDG et cofondateur de ZAPTA TechnologiesPublié le 13 min de lecture 11 sources citées
Résumer avec l'IA
Pressé ? Ouvrez cet article dans votre assistant IA avec une consigne prête à l'emploi.
- ChatGPT (s'ouvre dans un nouvel onglet avec une consigne de résumé)
- Perplexity (s'ouvre dans un nouvel onglet avec une consigne de résumé)
- Grok (s'ouvre dans un nouvel onglet avec une consigne de résumé)
Claude et Gemini s'ouvrent avec la consigne copiée : collez-la pour commencer.
Sur cette page
- Pourquoi un site s'affiche-t-il bien dans le navigateur mais n'apparaît-il pas dans la recherche ni dans les réponses des IA ?
- Les robots d'IA exécutent-ils JavaScript ?
- Comment vérifier en 10 minutes si les robots d'IA peuvent lire votre site ?
- À quoi ressemble un bon résultat pour chaque vérification ?
- Cloudflare bloque-t-il les robots d'IA sur mon site ?
- Pourquoi les balises canonical et les sitemaps comptent-ils pour la recherche IA ?
- Que révèle généralement un audit technique ?
- Comment ContentMas vérifie tout cela
- Questions fréquentes
Réponse courte
En bref : peut-être pas, même si le site s'affiche parfaitement dans votre navigateur. Les principaux robots d'IA (crawlers IA) n'exécutent pas JavaScript : le contenu qui n'apparaît qu'après le chargement des scripts leur reste donc invisible,1 et une règle robots.txt, une balise noindex ou un réglage de bots sur votre CDN peut leur fermer complètement la porte. Les huit vérifications ci-dessous prennent une dizaine de minutes et montrent si les moteurs de recherche et les assistants IA peuvent réellement lire vos pages.
La plainte classique : « Le site s'affiche bien, mais il n'apparaît ni dans Google ni dans les réponses des IA. » Un navigateur est un lecteur indulgent. Il exécute tous les scripts, suit toutes les redirections et ignore robots.txt. Les robots d'exploration sont plus stricts.
Ce guide traite de la tuyauterie, pas de la rédaction. Pour le volet contenu, consultez notre guide pour optimiser votre contenu pour ChatGPT, Perplexity et AI Overviews.
Pourquoi un site s'affiche-t-il bien dans le navigateur mais n'apparaît-il pas dans la recherche ni dans les réponses des IA ?
Parce qu'un robot d'exploration ne voit pas la même version de votre site que vous. Il peut être bloqué avant d'atteindre la page, recevoir un code d'erreur ou une longue chaîne de redirections, ou encore récupérer une coquille HTML vide qui ne devient une page qu'une fois JavaScript exécuté.
Rien de tout cela ne se voit à l'écran. Une page peut se charger rapidement pour les visiteurs pendant qu'une règle noindex demande à Google de l'exclure des résultats de recherche.2 Le Web Almanac 2024 montre à quel point ces signaux sont fréquents : la règle noindex figurait dans le HTML rendu de 3,9 % des pages mobiles, et 7,40 % des pages mobiles échouaient au test Lighthouse de validité du fichier robots.txt.3 Certains sont volontaires, d'autres sont des restes d'un environnement de préproduction.
Les robots d'IA exécutent-ils JavaScript ?
La plupart, non. Vercel a testé les principaux robots d'IA sur son réseau et a constaté qu'aucun d'eux n'exécutait JavaScript ; les robots de ChatGPT et de Claude téléchargeaient bien les fichiers JavaScript, mais sans les exécuter.1 Gemini, de Google, fait exception, car il s'appuie sur l'infrastructure de Googlebot, qui effectue le rendu des pages.1
Google exécute lui-même JavaScript, dans une étape distincte après l'exploration, mais il affirme que le rendu côté serveur ou le pré-rendu « reste une excellente idée », car tous les robots ne savent pas exécuter JavaScript.4 La règle pratique : votre texte principal, vos titres, vos liens et vos données structurées doivent figurer dans le HTML envoyé par le serveur, et non être ajoutés plus tard par un script.
La même étude a montré que le robot de ChatGPT consacrait 34,82 % de ses requêtes à des pages 404 et 14,36 % de plus à suivre des redirections, contre 8,22 % et 1,49 % pour Googlebot.1 Les URL cassées ou déplacées gaspillent une bonne part des efforts des robots d'IA.
Comment vérifier en 10 minutes si les robots d'IA peuvent lire votre site ?
Choisissez votre page d'accueil et une page interne clé, par exemple la page des tarifs. Chaque étape prend environ une minute.
- Lisez votre robots.txt. Ouvrez
yourdomain.com/robots.txt. CherchezDisallow: /sousUser-agent: *ou sous des robots d'IA nommés. Notre guide sur la visibilité dans les IA explique quels robots d'OpenAI, de Perplexity et de Google contrôlent l'inclusion dans la recherche et lesquels ne contrôlent que l'entraînement. - Vérifiez les réglages de bots de votre CDN. Si vous utilisez Cloudflare ou un service similaire, ouvrez ses réglages de bots ou de robots d'IA et confirmez qu'ils correspondent à ce que vous voulez (voir la section suivante).
- Cherchez
noindex. Affichez le code source de la page et rechercheznoindex. Vérifiez ensuite les en-têtes de réponse (outils de développement du navigateur, onglet Réseau) à la recherche d'un en-têteX-Robots-Tag. Google prend en charge cet en-tête pour les fichiers non HTML, comme les images.2 - Comparez le code source et la page rendue. Appuyez sur Ctrl+U (Cmd+Option+U sur Mac) et recherchez une phrase située au milieu de votre page. Si elle n'est pas dans le code source, elle est chargée par JavaScript, et beaucoup de robots d'IA ne la verront pas.1
- Vérifiez le code de statut et les redirections. Lancez
curl -I https://yourdomain.com/pageou utilisez un outil de vérification des redirections. Vous voulez un200sur l'URL finale, avec une redirection au maximum. Google n'indexe pas les URL qui renvoient un code 4xx, et ses robots suivent par défaut jusqu'à 10 redirections.5 Nous recommandons une seule redirection, car d'autres robots peuvent abandonner plus tôt. - Vérifiez la balise canonical. Recherchez
rel="canonical"dans le code source. Elle doit pointer vers l'URL propre de la page elle-même, écrite en URL absolue, comme le conseille Google.6 - Ouvrez votre sitemap. Essayez
yourdomain.com/sitemap.xmlet cherchez une ligneSitemap:dans robots.txt. Confirmez que la page importante y figure avec son URL complète.7 - Testez la vitesse et les données structurées. Passez la page dans PageSpeed Insights, puis dans le test des résultats enrichis de Google (Rich Results Test) pour repérer les erreurs de schema.8
Si une étape échoue, corrigez-la avant tout travail sur le contenu. Le contenu ne peut rien pour une page que les robots ne peuvent pas lire.
À quoi ressemble un bon résultat pour chaque vérification ?
| Vérification | Comment tester en 1 minute | Bon résultat | Outil |
|---|---|---|---|
| robots.txt | Ouvrez /robots.txt et lisez les règles | Les pages que vous voulez voir trouvées ne sont pas bloquées pour les robots des moteurs de recherche | Navigateur |
| Réglages de bots du CDN | Passez en revue les réglages des robots d'IA dans le tableau de bord de votre CDN | Les réglages correspondent à votre choix ; Cloudflare pose la question à chaque nouveau domaine lors de l'inscription9 | Tableau de bord Cloudflare |
| noindex / X-Robots-Tag | Cherchez noindex dans le code source ; lisez les en-têtes de réponse | Aucun noindex sur les pages que vous voulez voir dans la recherche ; la page est explorable pour que la règle puisse être lue2 | Code source, outils de développement |
| HTML rendu côté serveur | Retrouvez une phrase clé dans le code source | Le texte principal, les liens et le schema sont dans le HTML brut14 | Code source |
| Codes de statut et redirections | curl -I sur l'URL | 200 sur l'URL finale, une redirection au maximum ; jamais de 4xx pour des pages en ligne5 | curl, outil de vérification des redirections |
| Balise canonical | Cherchez rel="canonical" dans le code source | Une seule URL absolue pointant vers la version préférée6 | Code source |
| Sitemap XML | Ouvrez /sitemap.xml | URL absolues, moins de 50 000 URL ou 50 Mo par fichier, déclaré dans robots.txt7 | Navigateur, Search Console |
| Core Web Vitals | Lancez PageSpeed Insights | LCP ≤ 2,5 s, INP ≤ 200 ms, CLS ≤ 0,1 au 75e percentile10 | PageSpeed Insights |
| Données structurées | Collez l'URL dans le Rich Results Test | Aucune erreur ; un JSON-LD qui correspond au contenu visible8 | Rich Results Test |
Source : compilé par ContentMas à partir de Vercel, Cloudflare, Google Search Central et web.dev.1924567108
Un mot sur les Core Web Vitals : les seuils sont mesurés au 75e percentile des vraies visites de page, donc au moins trois visites sur quatre doivent atteindre chacun d'eux.10 La vitesse n'est pas un verrou comme robots.txt, mais des pages lentes pénalisent les visiteurs que les robots vous envoient.
Cloudflare bloque-t-il les robots d'IA sur mon site ?
C'est possible, et sans que vous l'ayez forcément choisi. Depuis juillet 2025, Cloudflare bloque par défaut les robots d'IA qui accèdent au contenu sans autorisation, et demande à chaque nouveau domaine, lors de l'inscription, s'il veut les autoriser.9
Cloudflare précise que ses clients peuvent vérifier leurs réglages et autoriser l'exploration à tout moment.9 Si votre site est derrière Cloudflare, ou derrière n'importe quel CDN ou pare-feu doté de règles sur les bots, faites-en une décision réfléchie. Un cas fréquent : le réglage a été choisi pendant la configuration par la personne qui s'occupait du DNS, et l'équipe marketing n'en a jamais entendu parler.
Bloquer l'entraînement des IA est un choix légitime. Assurez-vous simplement de ne pas bloquer en même temps les robots de recherche qui décident si vous apparaissez dans les réponses des IA.
Pourquoi les balises canonical et les sitemaps comptent-ils pour la recherche IA ?
Ils indiquent aux robots quelle URL est la bonne et où se trouvent vos pages importantes. Google qualifie rel="canonical" de « signal fort » pour désigner l'URL qui doit devenir canonique, et déconseille d'utiliser robots.txt pour la canonicalisation.6 Dans le Web Almanac 2024, 65 % des pages mobiles avaient une balise canonical.3
Quand il existe des doublons, par exemple à cause de paramètres de suivi ou de copies régionales, un robot peut lire la mauvaise version. Notre guide sur les pages à auditer en priorité explique comment les doublons s'installent.
Les sitemaps aident les robots à trouver les pages que les liens internes ne couvrent pas. Les limites de Google sont de 50 Mo non compressés ou 50 000 URL par fichier sitemap, avec des URL absolues, et vous pouvez signaler le sitemap dans robots.txt avec une ligne Sitemap:.7
Que révèle généralement un audit technique ?
Un audit technique révèle généralement quelques petits blocages faciles à corriger plutôt qu'une grosse défaillance : un noindex oublié, une balise canonical qui pointe vers la mauvaise URL, une chaîne de redirections héritée d'une migration, ou une section clé chargée uniquement par JavaScript.
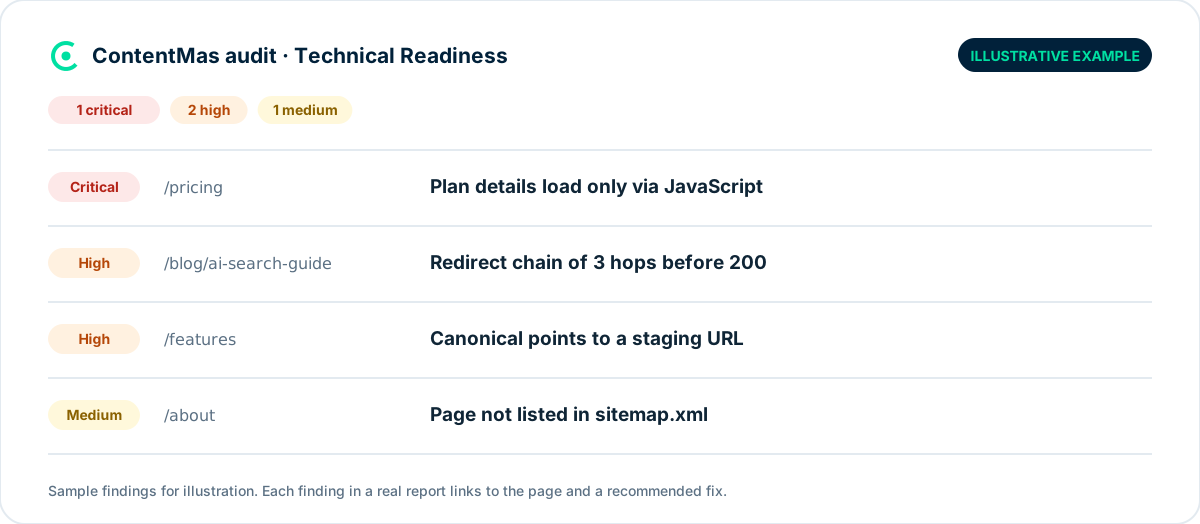
Source : exemple illustratif d'un rapport ContentMas pour un site fictif, pas des données réelles. Les vérifications présentées suivent les recommandations de Google Search Central.4567
Nous recommandons de corriger dans cet ordre : d'abord tout ce qui bloque l'accès (robots.txt, règles du CDN, noindex, erreurs 4xx et 5xx), puis le rendu, puis les balises canonical et les redirections, et enfin le sitemap, la vitesse et le schema. Google signale que les erreurs 5xx poussent ses robots à ralentir temporairement l'exploration,5 si bien que les erreurs serveur coûtent du temps d'exploration en plus de la page manquante.
Comment ContentMas vérifie tout cela
ContentMas audite vos pages clés selon plus de 600 KPI répartis en six piliers. Le pilier Préparation technique vérifie si les robots peuvent atteindre et lire chaque page : signaux d'exploration et d'indexation, codes de statut et redirections, configuration des balises canonical et du sitemap, part du contenu présente dans le HTML envoyé par le serveur, performances de la page et validité des données structurées.
Chaque constat reçoit une priorité critique, élevée, moyenne ou faible, ainsi qu'une recommandation de correctif, pour que vous sachiez quel blocage lever en premier. ContentMas mesure le niveau de préparation de votre site. Il ne suit pas la fréquence à laquelle les outils d'IA vous mentionnent. Lancez un audit gratuit sur 50 pages au maximum, ou lisez Notre méthode de notation pour voir comment les constats deviennent des scores.
À lire aussi : How to Optimize Your Content for ChatGPT, Perplexity, and AI Overviews · SEO vs GEO · Sécurité du site, SEO et confiance
Les guides des six piliers : Qualité du contenu · Confiance · Fraîcheur · Sécurité · SEO et GEO · Comment ContentMas note chaque pilier
Questions fréquentes
Comment savoir si les robots d'IA peuvent accéder à mon site ?
Vérifiez dans robots.txt les règles qui bloquent les robots d'IA, passez en revue les réglages de bots de votre CDN et assurez-vous que votre contenu principal figure dans le code source de la page au lieu d'être chargé par JavaScript. Les principaux robots d'IA n'exécutent pas JavaScript : un contenu absent du code source leur est donc probablement invisible aussi.1
Bloquer GPTBot retire-t-il mon site de la recherche ChatGPT ?
Pas à lui seul. OpenAI indique qu'OAI-SearchBot sert à faire apparaître des sites dans les fonctions de recherche de ChatGPT, tandis que GPTBot sert à l'entraînement des modèles, et que chaque réglage est indépendant des autres.11 Notre guide sur la visibilité dans les IA compare les principaux robots côte à côte.
Google a-t-il besoin du rendu côté serveur pour indexer mon site ?
Non. Google exécute JavaScript dans le cadre de l'exploration et de l'indexation.4 Mais Google qualifie toujours le rendu côté serveur ou le pré-rendu d'« excellente idée », car tous les robots ne savent pas exécuter JavaScript,4 et c'est le cas de la plupart des robots d'IA.1
Une balise noindex fonctionne-t-elle si robots.txt bloque la page ?
Non. Google explique que les directives de la balise meta robots et de l'en-tête X-Robots-Tag ne peuvent être lues et appliquées que si les robots sont autorisés à accéder à la page.2 Si vous voulez retirer une page de la recherche, autorisez l'exploration et utilisez noindex.
Les Core Web Vitals influencent-ils la visibilité dans la recherche IA ?
Aucune des plateformes d'IA que nous citons ne fait de la vitesse une condition pour être utilisé comme source. Nous recommandons tout de même d'atteindre les seuils « bons » : LCP de 2,5 secondes, INP de 200 millisecondes et CLS de 0,1,10 car les personnes qui cliquent depuis la recherche et les réponses des IA arrivent sur cette page.
Références
Chaque renvoi numéroté dans l'article mène à sa source ci-dessous.
-
Vercel — The rise of the AI crawler (s'ouvre dans un nouvel onglet), décembre 2024. ↩
-
Google Search Central — Robots meta tag, data-nosnippet, and X-Robots-Tag specifications (s'ouvre dans un nouvel onglet), mars 2026. ↩
-
HTTP Archive — Web Almanac 2024: SEO (s'ouvre dans un nouvel onglet), édition 2024. ↩
-
Google Search Central — Understand the JavaScript SEO basics (s'ouvre dans un nouvel onglet). ↩
-
Google Search Central — How HTTP status codes, and network and DNS errors affect Google Search (s'ouvre dans un nouvel onglet), février 2026. ↩
-
Google Search Central — How to specify a canonical with rel="canonical" and other methods (s'ouvre dans un nouvel onglet), juillet 2026. ↩
-
Google Search Central — Build and submit a sitemap (s'ouvre dans un nouvel onglet), juillet 2026. ↩
-
Google Search Central — General structured data guidelines (s'ouvre dans un nouvel onglet), juillet 2026. ↩
-
Cloudflare via Business Wire — Cloudflare Just Changed How AI Crawlers Scrape the Internet-at-Large; Permission-Based Approach Makes Way for A New Business Model (s'ouvre dans un nouvel onglet), juillet 2025. ↩
-
web.dev — How the Core Web Vitals metrics thresholds were defined (s'ouvre dans un nouvel onglet), mai 2025. ↩
-
OpenAI — Overview of OpenAI Crawlers (s'ouvre dans un nouvel onglet). ↩
À propos de cet article
Rédigé par Nasir Ali Joiya, PDG et cofondateur de ZAPTA Technologies. Relu par l’équipe ContentMas, qui développe ContentMas, un outil d’audit de site web qui vérifie les sites selon six piliers pour les moteurs de recherche et les assistants IA. Les faits et les chiffres renvoient à leurs sources d’origine dans les Références. Vous avez repéré une information dépassée ? Écrivez-nous et nous la corrigerons.
Audit de site web gratuit
Découvrez le score de votre site pour les moteurs de recherche et les assistants IA.
Un score global, six scores de piliers et une liste de correctifs classés en quelques minutes. Sans carte bancaire.
Lancer l'audit gratuit