
Préparation technique
Votre site bloque-t-il les robots d'IA ? Vérification en 10 minutes
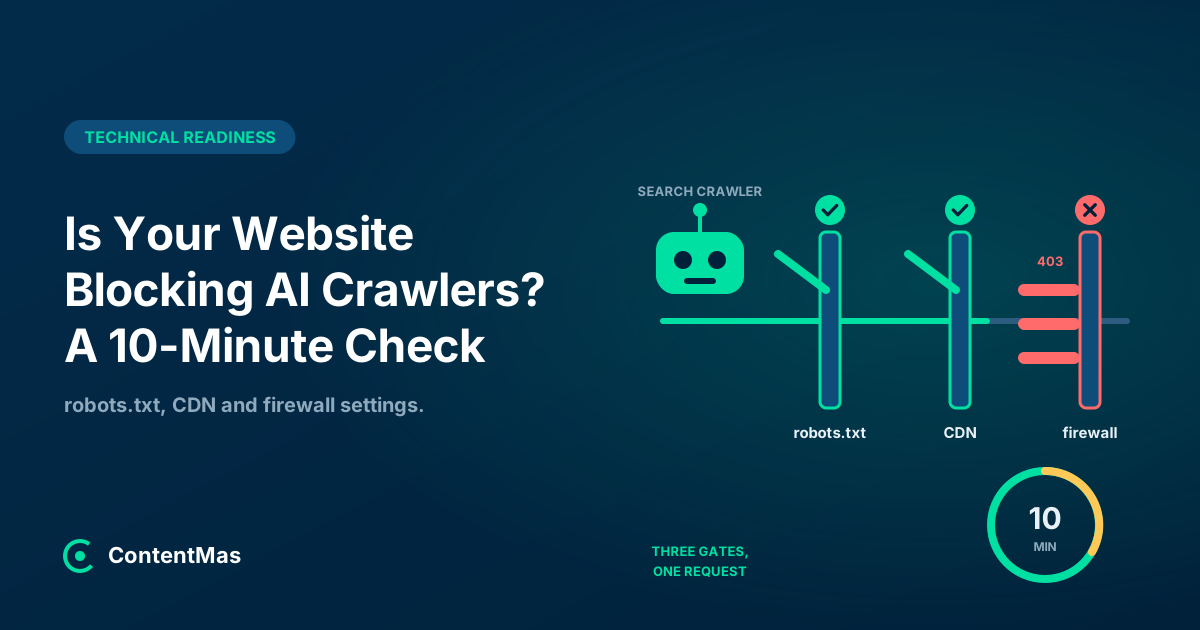
Un site web peut bloquer les robots d'IA dans robots.txt, dans les réglages anti-bots de son CDN ou dans un pare-feu, souvent sans que personne l'ait décidé. Trois vérifications en 10 minutes.
 Par Nasir Ali Joiya, PDG et cofondateur de ZAPTA TechnologiesPublié le 19 min de lecture 10 sources citées
Résumer avec l'IA
Pressé ? Ouvrez cet article dans votre assistant IA avec une consigne prête à l'emploi.
- ChatGPT (s'ouvre dans un nouvel onglet avec une consigne de résumé)
- Perplexity (s'ouvre dans un nouvel onglet avec une consigne de résumé)
- Grok (s'ouvre dans un nouvel onglet avec une consigne de résumé)
Claude et Gemini s'ouvrent avec la consigne copiée : collez-la pour commencer.
Sur cette page
- Où un site web peut-il bloquer les robots d'IA ?
- Quels robots d'IA décident si vous êtes cité ?
- Étape 1 : que dit vraiment votre robots.txt ? (3 minutes)
- Étape 2 : qu'a décidé votre CDN à votre place ? (3 minutes)
- Étape 3 : votre pare-feu laisse-t-il passer le robot ? (3 minutes)
- Que faut-il autoriser et que faut-il bloquer ?
- Comment ContentMas aide-t-il face au blocage des robots d'IA ?
- Points clés à retenir
- Questions fréquentes
Réponse courte
En bref : le blocage des robots d'IA peut se produire à trois endroits : le fichier robots.txt, les réglages anti-bots du CDN, et le pare-feu du serveur ou l'extension de sécurité, et la plupart des propriétaires ne vérifient jamais que le premier. Ces réglages ont souvent été choisis par un hébergeur ou par un paramètre par défaut, pas par vous : Cloudflare attribue désormais à tout nouveau domaine l'un de deux préréglages selon qu'il affiche ou non des publicités, et a migré en septembre 2026 tous les anciens domaines « Block AI Bots » vers de nouvelles règles,1 et le conseil de Google pour apparaître dans ses fonctionnalités IA est de s'assurer que « l'exploration est autorisée dans robots.txt, ainsi que par tout CDN ou toute infrastructure d'hébergement ».2 Chaque entreprise d'IA exploite des robots distincts pour l'entraînement, la recherche et les requêtes des utilisateurs, chacun avec son propre interrupteur,3 si bien que la vérification confirme que les robots qui décident si vous êtes cité ne sont pas pris dans une règle prévue pour autre chose. Les trois étapes ci-dessous prennent environ dix minutes.
Vous lisez que les assistants IA envoient des visiteurs, vous vérifiez, et votre site n'apparaît jamais. Le robots.txt semble inoffensif, d'où la conclusion : « notre contenu n'est pas assez bon ».
Souvent, le robot n'est jamais entré. Un interrupteur du CDN choisi à l'inscription, une extension de sécurité qui bloque les « mauvais bots » d'après leur user-agent, ou une limitation de débit qui renvoie un 403 à tout ce qui télécharge vite peuvent fermer la porte aux robots de recherche de ChatGPT, Claude, Perplexity et Google sans une seule ligne dans robots.txt.
Ce guide ne traite que de l'accès. Savoir si le robot peut lire ce qu'il trouve (JavaScript, noindex, redirections) est le sujet de la vérification technique en 10 minutes.
Où un site web peut-il bloquer les robots d'IA ?
À trois niveaux, et un robot doit franchir les trois. Le premier est indicatif, les deux autres sont appliqués de force.
| Niveau | Ce qu'il fait | Qui l'a généralement configuré | Comment un robot bloqué le perçoit |
|---|---|---|---|
| robots.txt | Demande aux robots de ne pas explorer certains chemins ou tout le site | Développeur, extension SEO, ou le CDN en votre nom | Lit la règle et s'en va (s'il la respecte) |
| Réglages anti-bots du CDN (Cloudflare, Vercel et autres) | Bloque ou soumet à un défi les requêtes par catégorie de bot avant qu'elles n'atteignent votre serveur | La personne qui a configuré le DNS, ou un réglage par défaut à l'inscription | 403, une page de défi ou une connexion coupée |
| Pare-feu, WAF, extension de sécurité, limitation de débit | Bloque selon le user-agent, la plage d'IP ou la vitesse des requêtes sur le serveur | Hébergeur ou extension de sécurité | 403, 401, 429 ou un délai dépassé |
Le premier niveau est volontaire par conception. Les robots qui récupèrent une page parce qu'une personne l'a demandée le disent dans leur propre documentation : OpenAI précise, au sujet de ChatGPT-User, que « comme ces actions sont lancées par un utilisateur, les règles de robots.txt peuvent ne pas s'appliquer »,3 et Perplexity indique pour Perplexity-User que « puisqu'un utilisateur a demandé la récupération, ce fetcher ignore généralement les règles de robots.txt ».4 Les deuxième et troisième niveaux sont ceux où les sites se retrouvent bloqués sans le vouloir, parce que les règles y sont écrites pour les « bots » en général.
Ce que dit robots.txt et ce que fait le serveur sont deux choses différentes, dans les deux sens. La vérification doit couvrir les deux.
Quels robots d'IA décident si vous êtes cité ?
Les robots de recherche et ceux déclenchés par les utilisateurs, pas les robots d'entraînement. Chaque grande entreprise d'IA sépare son trafic en plusieurs user-agents, et chacun a son propre réglage.
| Entreprise | Robot d'entraînement | Robot de recherche ou d'indexation | Fetcher déclenché par l'utilisateur | Ce que dit la documentation |
|---|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User | « Chaque réglage est indépendant des autres » ; les sites qui refusent OAI-SearchBot « ne seront pas affichés dans les réponses de ChatGPT search »3 |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User | Désactiver Claude-SearchBot « peut réduire la visibilité et l'exactitude de votre site dans les résultats de recherche des utilisateurs »6 |
| Perplexity | Aucun indiqué ; PerplexityBot « n'est pas utilisé pour explorer du contenu destiné aux modèles de fondation » | PerplexityBot | Perplexity-User | Recommande d'autoriser PerplexityBot et ses plages d'IP publiées4 |
| Google-Extended (un simple jeton robots.txt) | Googlebot | Non traité ici | Les règles robots.txt pour Googlebot sont « le moyen de contrôle » pour AI Overviews et AI Mode2 ; Google-Extended « n'a pas d'incidence sur l'inclusion d'un site dans Google Search »7 |
Deux détails comptent pour la vérification. D'abord, un site qui refuse OAI-SearchBot peut « toujours apparaître sous forme de liens de navigation », mais pas dans les réponses de recherche,3 si bien qu'un blocage du mauvais bot ne ressemble pas à un blocage dans vos journaux : le trafic ne vient simplement jamais. Ensuite, Google-Extended « n'a pas de chaîne user-agent HTTP distincte » ; « le jeton user-agent de robots.txt sert de moyen de contrôle ».7 Une règle de pare-feu ne peut jamais le cibler, et une règle robots.txt à son nom ne change rien pour Search : elle contrôle seulement si Google utilise vos pages pour entraîner et ancrer ses modèles Gemini.7
Bloquer les robots d'entraînement est un choix légitime. L'erreur, c'est une règle écrite pour GPTBot ou pour les « bots IA » qui attrape discrètement OAI-SearchBot, Claude-SearchBot et PerplexityBot avec eux.
Étape 1 : que dit vraiment votre robots.txt ? (3 minutes)
Ouvrez yourdomain.com/robots.txt dans un navigateur, puis récupérez-le en ligne de commande pour voir le code de statut qu'obtient un robot :
curl -s -o /dev/null -w "%{http_code}\n" https://yourdomain.com/robots.txt
curl -s https://yourdomain.com/robots.txt
Cherchez quatre choses.
1. Les règles générales
User-agent: * suivi de Disallow: / bloque tous les robots qui le respectent, moteurs de recherche compris. Un Disallow: / sous le nom d'un bot d'IA ne bloque que ce bot. Lisez chaque bloc User-agent : une règle pour GPTBot est acceptable si vous l'avez voulue, une règle pour OAI-SearchBot ou PerplexityBot signifie que vous avez renoncé à être cité.
2. Les lignes que vous n'avez pas écrites
Votre CDN peut ajouter des lignes à ce fichier, et en retirer. HasData a trouvé une directive de refus de l'IA dans le robots.txt archivé de 118 sites derrière Cloudflare en juillet 2026, et sur aucun de ces sites le 16 septembre 2026 ; parmi les sites derrière Cloudflare, la part interdisant GPTBot est passée de 17.1 % à 9.9 % entre les deux relevés, tandis que les sites sans Cloudflare sont passés de 18.7 % à 18.6 %.5 Si une ligne que vous n'avez jamais modifiée apparaît ou disparaît, le réglage qui la génère se trouve dans le tableau de bord du CDN, pas dans le fichier.
3. Le code de statut
Google traite « toutes les erreurs 4xx, sauf 429, comme si aucun fichier robots.txt valide n'existait », donc un fichier manquant signifie aucune restriction.8 Un 5xx, c'est l'inverse : « Pendant les 12 premières heures, Google cesse d'explorer le site mais continue d'essayer de récupérer le fichier robots.txt », puis utilise la dernière version valide pendant 30 jours au plus.8 Un robots.txt qui expire ou renvoie une erreur serveur à cause d'une règle de pare-feu est un arrêt de l'exploration de tout le site, et il ressemble à un fichier normal dans votre navigateur.
4. Le délai de prise en compte d'un changement
Google « met généralement en cache le contenu du fichier robots.txt pendant 24 heures au plus ».8 OpenAI indique qu'« il peut s'écouler ~24 heures entre la mise à jour du robots.txt d'un site et l'ajustement de nos systèmes » pour la recherche,3 et Perplexity précise que les changements peuvent prendre « jusqu'à 24 heures » pour être pris en compte.4 Corrigez le fichier, puis attendez une journée avant de juger du résultat.
Étape 2 : qu'a décidé votre CDN à votre place ? (3 minutes)
Ouvrez la section bots ou robots d'IA du tableau de bord de votre CDN et lisez l'état actuel de chaque catégorie. C'est là qu'une décision a très probablement été prise sans vous.
Cloudflare
Cloudflare a remplacé son interrupteur unique « Block AI Bots » (bloquer les bots IA) par trois politiques : « Search » (recherche : exploration pour constituer un index de recherche), « Training » (entraînement : exploration pour entraîner ou affiner un modèle) et « Agent » (agents dirigés par l'utilisateur, qui visitent une page pour le compte d'un humain).1 Depuis le 15 septembre 2026, un nouveau domaine se voit proposer l'un de deux préréglages. Un site qui « ne se monétise pas par la publicité » obtient Search, Training et Agent tous réglés sur Allow (autoriser) ; un site « monétisé par la publicité » obtient Search sur Allow, Training sur « Disallow AI Training » (interdire l'entraînement de l'IA) et Agent sur « Block on pages with ads » (bloquer sur les pages avec publicités).1
Les clients existants ont été migrés. Un domaine qui n'avait jamais touché aux réglages détaillés et dont l'ancien interrupteur « Block AI Bots » était activé a maintenant Search sur Allow, Training sur Disallow AI Training et Agent sur Block on pages with ads.1 Bonne nouvelle pour tous ceux qui ont activé l'interrupteur en 2025 et se sont ensuite demandé pourquoi ChatGPT avait cessé de les citer : l'exploration pour la recherche est de nouveau autorisée. Mais lisez vous-même la ligne Search, car « Block et Block on pages with ads s'appliquent désormais aux robots à usage mixte, dont Applebot, Bingbot et Googlebot », si bien que « l'un comme l'autre de ces réglages touche la recherche autant que l'entraînement ».1 Un Block sur Search vous cache aussi de Google. Pour garder la recherche et arrêter l'entraînement, le réglage est Disallow AI Training : « Sous Disallow AI Training, ils peuvent continuer à explorer votre site pour la recherche. »1
Vercel
L'AI Bots Managed Ruleset de Vercel est « inactif par défaut », affiché comme Allow, et vous permet de « bloquer indépendamment les catégories AI Crawlers ou AI Assistants ».9 Les catégories sont précises : « AI Crawlers : bots qui explorent et collectent du contenu pour l'entraînement » et « AI Assistants : bots qui récupèrent des pages en réponse à des actions d'utilisateurs ou pour des requêtes de recherche ».9 Régler Deny (refuser) sur AI Assistants « bloque tout le trafic identifié comme provenant de bots IA pour cette catégorie »,9 c'est-à-dire le trafic de recherche que vous voulez. Deny sur AI Crawlers seul est le refus limité à l'entraînement.
Autres CDN et hébergeurs
Les deux mêmes questions s'appliquent partout : existe-t-il une catégorie de bots qui couvre les robots de recherche ou les assistants, et quelle est l'action associée ? Si le tableau de bord ne propose qu'un seul interrupteur « bloquer les bots IA », partez du principe qu'il bloque aussi les robots de recherche tant que la documentation du fournisseur ne dit pas le contraire.
Étape 3 : votre pare-feu laisse-t-il passer le robot ? (3 minutes)
Récupérez votre page d'accueil deux fois : une fois comme un navigateur, une fois avec le user-agent d'un vrai robot d'IA, et comparez les codes de statut.
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36" https://yourdomain.com/
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot" https://yourdomain.com/
La deuxième chaîne est le user-agent publié d'OAI-SearchBot ;3 répétez l'opération avec PerplexityBot/1.04 et ClaudeBot.6 Les deux requêtes doivent renvoyer 200. Si la requête du robot renvoie 403, 401 ou 429, ou une page de défi, quelque chose sur le serveur ou dans le WAF cible le user-agent. C'est le test que HasData a mené à grande échelle, celui qui a révélé un écart de 30 points entre les navigateurs et GPTBot sur les sites d'éditeurs.5
Un 403 est le pire des trois pour la recherche, parce que les robots l'interprètent comme « le contenu n'existe pas ». Google est direct : « Google n'utilise pas le contenu des URL qui renvoient des codes de statut 4xx », et « le pipeline d'indexation retire l'URL de l'index si elle était déjà indexée ».10 Il prévient aussi : « N'utilisez pas les codes de statut 401 et 403 pour limiter la vitesse d'exploration. »10 Un 429 ou un 5xx est lu comme une surcharge : ces erreurs « incitent les robots de Google à ralentir temporairement l'exploration », et les URL déjà indexées « sont conservées dans l'index, mais finissent par être retirées ».10 Une règle large qui cible le mot « bot » dans n'importe quel user-agent fait la même chose à Googlebot et à Bingbot.
Trois endroits à examiner quand le test échoue :
- Le WAF ou l'extension de sécurité. Cherchez dans ses règles « user agent », « bad bots », « AI bots » et « crawler ». Si l'extension tient une liste de user-agents bloqués, ouvrez-la et vérifiez si le robot d'un moteur de recherche IA y figure.
- La limitation de débit. Les robots récupèrent beaucoup de pages en peu de temps. Si la limite renvoie
403au lieu de429, chaque page touchée est considérée comme disparue.10 - Les blocages d'IP. OpenAI, Anthropic et Perplexity publient les plages d'IP qu'utilisent leurs robots, ce qui permet de vérifier qu'un robot est authentique plutôt que de le deviner d'après le user-agent ;364 Perplexity précise que « chaque bot a ses propres plages d'IP, donc faites correspondre chaque User-Agent à ses propres plages d'IP ».4 Utilisez ces listes pour autoriser, pas comme moyen de refus : Anthropic avertit que bloquer ses adresses IP « peut ne pas fonctionner correctement ni garantir durablement un refus, car cela nous empêche de lire votre fichier robots.txt ».6
Que faut-il autoriser et que faut-il bloquer ?
Décidez par finalité, pas par entreprise. Les robots de recherche et ceux déclenchés par les utilisateurs vous font citer ; l'entraînement est une question à part, avec un interrupteur à part chez chaque fournisseur.3647
| Objectif | robots.txt | CDN | Pare-feu |
|---|---|---|---|
| Être cité par les assistants IA et garder Google | Autoriser OAI-SearchBot, Claude-SearchBot, PerplexityBot et Googlebot | Catégorie Search ou Assistants réglée sur Allow | Aucune règle de user-agent ou de débit ne leur renvoie 403 |
| Garder cela, mais refuser l'entraînement des modèles | Ajouter Disallow: / pour GPTBot, ClaudeBot et Google-Extended | Training sur Disallow AI Training (Cloudflare) ou Deny sur AI Crawlers (Vercel) | Rien de plus |
| Rester totalement hors des réponses IA | Interdire aussi les robots de recherche | Bloquer la catégorie Search ou Assistants | Facultatif, pour les robots qui ignorent robots.txt |
Seule la troisième ligne coûte de la visibilité dans les moteurs de recherche IA. La deuxième est gratuite : Google indique que Google-Extended « n'est pas utilisé comme signal de classement dans Google Search »,7 et OpenAI précise qu'un site peut « autoriser OAI-SearchBot pour apparaître dans les résultats de recherche tout en interdisant GPTBot ».3
Comment ContentMas aide-t-il face au blocage des robots d'IA ?
ContentMas est un outil SEO propulsé par l'IA qui audite votre site web pour Google et les moteurs de recherche IA, et vous montre précisément quoi corriger pour gagner des places et être cité. Ses vérifications de Préparation technique examinent si les robots peuvent atteindre et lire chaque page : les règles robots.txt qui s'appliquent aux robots de recherche et d'IA, le code de statut renvoyé par le fichier et par les pages, les redirections, et la part du contenu présente dans le HTML envoyé par le serveur. Son pilier Préparation SEO et GEO (visibilité dans Google et les moteurs de recherche IA ; GEO signifie Generative Engine Optimization) vérifie que les pages qui passent peuvent être trouvées et citées.
Chaque constat s'accompagne de sa preuve et d'un correctif, classés par impact, sur six piliers et 600+ KPI. Le plan gratuit lit jusqu'à 10 pages par scan, 3 scans par 24 heures. Découvrez notre méthode de notation ou lancez un audit.
Points clés à retenir
- Un site peut bloquer les robots d'IA dans robots.txt, dans les réglages anti-bots du CDN et dans le pare-feu ; robots.txt est indicatif, les deux autres sont appliqués de force, et les trois doivent être vérifiés.345
- Les robots d'entraînement, de recherche et déclenchés par les utilisateurs sont des user-agents distincts avec des interrupteurs distincts chez OpenAI, Anthropic et Perplexity ; Google-Extended est un jeton robots.txt sans user-agent, et il n'a jamais d'effet sur Google Search.3647
- HasData a constaté que 39.5 % des sites qui interdisent GPTBot lui servent quand même des pages, et que les éditeurs répondent au user-agent de GPTBot 30 points moins souvent qu'à un navigateur : le fichier et le serveur se contredisent dans les deux sens.5
- Cloudflare sépare désormais le trafic IA en Search, Training et Agent, a migré les anciens domaines « Block AI Bots » vers Search Allow, et prévient qu'un Block sur Search bloque aussi Googlebot et Bingbot.1
- Un
403du pare-feu dit à Google que la page n'existe pas et la retire de l'index ; un429ne fait que ralentir l'exploration.10 Testez avec le user-agent d'un vrai robot et attendez-vous à un200.3
Dix minutes suffisent pour savoir si le problème vient de votre contenu ou de vos portails. Ouvrez le fichier, ouvrez le tableau de bord, lancez deux requêtes. Si les trois niveaux laissent passer les robots de recherche, ce qui reste est une question de contenu.
À lire aussi : Les robots d'IA peuvent-ils lire votre site ? Vérification technique en 10 minutes et Comment la sécurité de votre site influence le classement et la confiance des clients
Les guides des six piliers : Technique · Qualité du contenu · Confiance · Fraîcheur · Sécurité · SEO et GEO · Comment ContentMas note chaque pilier
Questions fréquentes
Bloquer GPTBot exclut-il mon site de ChatGPT search ?
Non. OpenAI utilise GPTBot pour l'entraînement et OAI-SearchBot pour la recherche, et précise que « chaque réglage est indépendant des autres ».3 Seuls les sites qui refusent OAI-SearchBot « ne seront pas affichés dans les réponses de ChatGPT search », bien qu'ils « puissent toujours apparaître sous forme de liens de navigation ».3
Bloquer Google-Extended retire-t-il mes pages d'AI Overviews ?
Non. Google indique que Google-Extended « n'a pas d'incidence sur l'inclusion d'un site dans Google Search et n'est pas utilisé comme signal de classement », et qu'il contrôle seulement si le contenu exploré sert à entraîner et à ancrer les modèles Gemini.7 Le moyen de contrôle pour AI Overviews et AI Mode est la règle robots.txt pour Googlebot, et Google demande que l'exploration soit aussi autorisée « par tout CDN ou toute infrastructure d'hébergement ».2
J'ai activé « Block AI Bots » de Cloudflare en 2025. Bloque-t-il encore les robots de recherche ?
Probablement pas. Cloudflare a migré les domaines qui n'avaient jamais utilisé les réglages détaillés vers Search Allow, Training « Disallow AI Training » et Agent « Block on pages with ads ».1 Ouvrez la politique Search et confirmez qu'elle indique Allow, car un Block à cet endroit s'applique désormais aussi à Googlebot, Bingbot et Applebot.1
Combien de temps après un changement de robots.txt un robot s'en aperçoit-il ?
Environ une journée. Google met robots.txt en cache « pendant 24 heures au plus »,8 OpenAI indique que ses systèmes de recherche mettent « ~24 heures » à s'ajuster,3 et Perplexity précise que les changements peuvent prendre « jusqu'à 24 heures ».4 Un changement de pare-feu prend effet dès la requête suivante.
Un pare-feu peut-il bloquer les robots d'IA qui ignorent robots.txt ?
Oui, et c'est le bon outil pour les fetchers déclenchés par les utilisateurs comme ChatGPT-User et Perplexity-User, dont la propre documentation indique que les règles de robots.txt peuvent ne pas s'appliquer à eux.34 Ciblez-les par user-agent et par les plages d'IP que publient les fournisseurs,34 et ne renvoyez un 403 qu'aux robots que vous voulez réellement refuser, jamais aux robots de recherche.10
Références
Chaque renvoi numéroté dans l'article mène à sa source ci-dessous.
-
Cloudflare — Have it both ways: stay discoverable in search while disallowing AI training (s'ouvre dans un nouvel onglet), septembre 2026. ↩
-
Google Search Central — AI features and your website (s'ouvre dans un nouvel onglet), décembre 2025. ↩
-
OpenAI — Overview of OpenAI Crawlers (s'ouvre dans un nouvel onglet), consulté en novembre 2026. ↩
-
Perplexity — Perplexity Crawlers (s'ouvre dans un nouvel onglet), consulté en novembre 2026. ↩
-
HasData — The AI Crawler Block Index (s'ouvre dans un nouvel onglet), octobre 2026. ↩
-
Anthropic — Does Anthropic crawl data from the web, and how can site owners block the crawler? (s'ouvre dans un nouvel onglet), octobre 2026. ↩
-
Google Search Central — Google's common crawlers (s'ouvre dans un nouvel onglet), octobre 2026. ↩
-
Google Search Central — How Google interprets the robots.txt specification (s'ouvre dans un nouvel onglet), octobre 2026. ↩
-
Vercel — WAF Managed Rulesets (s'ouvre dans un nouvel onglet), septembre 2026. ↩
-
Google Search Central — How HTTP status codes affect Google's crawlers (s'ouvre dans un nouvel onglet), février 2026. ↩
À propos de cet article
Rédigé par Nasir Ali Joiya, PDG et cofondateur de ZAPTA Technologies. Relu par l’équipe ContentMas, qui développe ContentMas, un outil d’audit SEO propulsé par l’IA qui vérifie les sites selon six piliers pour Google et les moteurs de recherche IA. Les faits et les chiffres renvoient à leurs sources d’origine dans les Références. Vous avez repéré une information dépassée ? Écrivez-nous et nous la corrigerons.
Audit de site web gratuit
Découvrez le score de votre site pour les moteurs de recherche et les assistants IA.
Un score global, six scores de piliers et une liste de correctifs classés en quelques minutes. Sans carte bancaire.
Lancer l'audit gratuit