
Preparación técnica
¿Pueden los rastreadores de IA leer tu web? Una comprobación técnica de 10 minutos
Muchos rastreadores de IA solo leen el HTML sin procesar y respetan robots.txt. Revisa el acceso, noindex, el renderizado, los códigos de estado, canonicals, sitemap, velocidad y schema en 10 minutos.
 Por Nasir Ali Joiya, CEO y cofundador de ZAPTA TechnologiesPublicado el 13 min de lectura 11 fuentes citadas
Resumir con IA
¿Poco tiempo? Abre este artículo en tu asistente de IA con una instrucción ya preparada.
- ChatGPT (se abre en una pestaña nueva con una instrucción de resumen)
- Perplexity (se abre en una pestaña nueva con una instrucción de resumen)
- Grok (se abre en una pestaña nueva con una instrucción de resumen)
Claude y Gemini se abren con la instrucción copiada: pégala para empezar.
En esta página
- ¿Por qué una web se ve bien en el navegador pero no aparece en la búsqueda ni en las respuestas de la IA?
- ¿Los rastreadores de IA renderizan JavaScript?
- ¿Cómo comprobar en 10 minutos si los rastreadores de IA pueden leer tu web?
- ¿Qué resultado es bueno en cada comprobación?
- ¿Está Cloudflare bloqueando los rastreadores de IA en mi web?
- ¿Por qué importan los canonicals y los sitemaps para la búsqueda con IA?
- ¿Qué suele encontrar una auditoría técnica?
- Cómo lo comprueba ContentMas
- Preguntas frecuentes
Respuesta breve
En resumen: quizá no, aunque la web se vea perfecta en tu navegador. Los principales rastreadores de IA no ejecutan JavaScript, así que el contenido que solo aparece después de cargar los scripts les resulta invisible,1 y una regla de robots.txt, una etiqueta noindex o un ajuste de bots de tu CDN pueden dejarlos fuera por completo. Las ocho comprobaciones de abajo llevan unos diez minutos y muestran si los buscadores y los asistentes de IA pueden leer de verdad tus páginas.
La queja habitual: "La web se ve bien, pero no aparece en Google ni en las respuestas de la IA". Un navegador es un lector indulgente. Ejecuta todos los scripts, sigue todas las redirecciones e ignora robots.txt. Los rastreadores son más estrictos.
Esta guía trata de la infraestructura técnica, no de la redacción. Para la parte de contenido, consulta nuestra guía sobre cómo optimizar el contenido para ChatGPT, Perplexity y AI Overviews (en inglés).
¿Por qué una web se ve bien en el navegador pero no aparece en la búsqueda ni en las respuestas de la IA?
Porque un rastreador ve una versión de tu web distinta de la que ves tú. Puede quedar bloqueado antes de llegar a la página, puede recibir un código de error o una larga cadena de redirecciones, o puede recibir un esqueleto HTML vacío que solo se convierte en página cuando se ejecuta JavaScript.
Nada de esto se ve en pantalla. Una página puede cargar rápido para los visitantes mientras una regla noindex le indica a Google que la deje fuera de los resultados de búsqueda.2 El Web Almanac de 2024 muestra lo comunes que son estas señales: la regla noindex aparecía en el HTML renderizado del 3,9 % de las páginas móviles, y el 7,40 % de las páginas móviles no superaba la comprobación de Lighthouse de un archivo robots.txt válido.3 Algunas son intencionadas; otras son restos de entornos de pruebas (staging).
¿Los rastreadores de IA renderizan JavaScript?
La mayoría no. Vercel analizó los principales rastreadores de IA en toda su red y comprobó que ninguno renderizaba JavaScript; los rastreadores de ChatGPT y Claude descargaban archivos JavaScript, pero no los ejecutaban.1 Gemini, de Google, es la excepción, porque usa la infraestructura de Googlebot, que sí renderiza las páginas.1
Google sí renderiza JavaScript, como un paso aparte después del rastreo, pero aun así afirma que el renderizado en el servidor o el prerrenderizado "sigue siendo una gran idea", porque no todos los bots pueden ejecutar JavaScript.4 La regla práctica: el texto principal, los encabezados, los enlaces y los datos estructurados deben estar en el HTML que envía el servidor, no añadirse después con un script.
El mismo estudio descubrió que el rastreador de ChatGPT dedicó el 34,82 % de sus solicitudes a páginas 404 y otro 14,36 % a seguir redirecciones, frente al 8,22 % y el 1,49 % de Googlebot.1 Las URL rotas y trasladadas desperdician buena parte del esfuerzo de los rastreadores de IA.
¿Cómo comprobar en 10 minutos si los rastreadores de IA pueden leer tu web?
Elige tu página de inicio y una página interna clave, como la de precios. Cada paso lleva más o menos un minuto.
- Lee tu robots.txt. Abre
yourdomain.com/robots.txt. BuscaDisallow: /bajoUser-agent: *o bajo bots de IA concretos. Nuestra guía de visibilidad en IA (en inglés) explica qué rastreadores de OpenAI, Perplexity y Google controlan la inclusión en la búsqueda y cuáles solo controlan el entrenamiento. - Revisa los ajustes de bots de tu CDN. Si usas Cloudflare o un servicio similar, abre sus ajustes de bots o de rastreadores de IA y confirma que coinciden con lo que quieres (consulta la siguiente sección).
- Busca
noindex. Abre el código fuente de la página y buscanoindex. Después revisa las cabeceras de respuesta (DevTools del navegador, pestaña Network) por si hay una cabeceraX-Robots-Tag. Google admite esa cabecera para archivos que no son HTML, como las imágenes.2 - Compara el código fuente con la página renderizada. Pulsa Ctrl+U (Cmd+Option+U en Mac) y busca una frase de la mitad de la página. Si no está en el código fuente, la carga JavaScript, y muchos rastreadores de IA no la verán.1
- Comprueba el código de estado y las redirecciones. Ejecuta
curl -I https://yourdomain.com/pageo usa un comprobador de redirecciones. Lo que buscas es un200en la URL final con un salto como máximo. Google no indexa las URL que devuelven un código 4xx, y sus rastreadores siguen hasta 10 saltos de redirección de forma predeterminada.5 Recomendamos un solo salto, porque otros rastreadores pueden rendirse antes. - Revisa la etiqueta canonical. Busca
rel="canonical"en el código fuente. Debe apuntar a la URL limpia de la propia página, escrita como URL absoluta, como aconseja Google.6 - Abre tu sitemap. Prueba
yourdomain.com/sitemap.xmly busca una líneaSitemap:en robots.txt. Confirma que la página importante aparece con su URL completa.7 - Prueba la velocidad y los datos estructurados. Pasa la página por PageSpeed Insights y luego por la prueba de resultados enriquecidos (Rich Results Test) de Google para detectar errores de schema.8
Si falla algún paso, corrígelo antes de ponerte con el contenido. El contenido no puede ayudar a una página que los rastreadores no pueden leer.
¿Qué resultado es bueno en cada comprobación?
| Comprobación | Cómo probarlo en 1 minuto | Cómo se ve un buen resultado | Herramienta |
|---|---|---|---|
| robots.txt | Abre /robots.txt y lee las reglas | Las páginas que quieres que se encuentren no están bloqueadas para los rastreadores de búsqueda | Navegador |
| Ajustes de bots de la CDN | Revisa los ajustes de rastreadores de IA en el panel de tu CDN | Los ajustes coinciden con tu decisión; Cloudflare lo pregunta a los dominios nuevos al registrarse9 | Panel de Cloudflare |
| noindex / X-Robots-Tag | Busca noindex en el código fuente; lee las cabeceras de respuesta | Sin noindex en las páginas que quieres en la búsqueda; la página se puede rastrear para que la regla se pueda leer2 | Código fuente, DevTools |
| HTML renderizado en el servidor | Busca una frase clave en el código fuente | El texto principal, los enlaces y el schema están en el HTML sin procesar14 | Código fuente |
| Códigos de estado y redirecciones | Ejecuta curl -I sobre la URL | 200 en la URL final, como máximo un salto de redirección; nunca 4xx en páginas activas5 | curl, comprobador de redirecciones |
| Etiqueta canonical | Busca rel="canonical" en el código fuente | Una URL absoluta que apunta a la versión preferida6 | Código fuente |
| Sitemap XML | Abre /sitemap.xml | URL absolutas, menos de 50 000 URL o 50 MB por archivo, indicado en robots.txt7 | Navegador, Search Console |
| Core Web Vitals | Ejecuta PageSpeed Insights | LCP ≤ 2,5 s, INP ≤ 200 ms, CLS ≤ 0,1 en el percentil 7510 | PageSpeed Insights |
| Datos estructurados | Pega la URL en la prueba de resultados enriquecidos | Sin errores; JSON-LD que coincide con el contenido visible8 | Rich Results Test |
Fuente: recopilado por ContentMas a partir de Vercel, Cloudflare, Google Search Central y web.dev.1924567108
Una nota sobre las Core Web Vitals: los umbrales se miden en el percentil 75 de las visitas reales a la página, así que al menos tres de cada cuatro visitas deben cumplir cada uno.10 La velocidad no es una barrera como robots.txt, pero las páginas lentas perjudican a los visitantes que te envían los rastreadores.
¿Está Cloudflare bloqueando los rastreadores de IA en mi web?
Puede que sí, y quizá no lo hayas elegido tú. Desde julio de 2025, Cloudflare bloquea de forma predeterminada los rastreadores de IA que acceden al contenido sin permiso, y pregunta a cada dominio nuevo al registrarse si quiere permitirlos.9
Cloudflare indica que los clientes pueden revisar sus ajustes y habilitar el rastreo en cualquier momento.9 Si tu web está detrás de Cloudflare, o de cualquier CDN o firewall con reglas para bots, toma esta decisión de forma consciente. Es habitual que el ajuste lo eligiera durante la configuración quien se encargó del DNS, sin que el equipo de marketing se enterara nunca.
Bloquear el entrenamiento de IA es una opción válida. Solo asegúrate de no bloquear también los rastreadores de búsqueda que deciden si apareces en las respuestas de la IA.
¿Por qué importan los canonicals y los sitemaps para la búsqueda con IA?
Indican a los rastreadores cuál es la URL auténtica y dónde están tus páginas importantes. Google califica rel="canonical" como "una señal fuerte" de qué URL debe ser la canónica, y advierte de que no se use robots.txt para la canonicalización.6 En el Web Almanac de 2024, el 65 % de las páginas móviles tenía etiqueta canonical.3
Cuando hay duplicados, como parámetros de seguimiento o copias regionales, un rastreador puede leer la versión equivocada. Nuestra guía sobre qué páginas auditar primero (en inglés) explica cómo aparecen los duplicados.
Los sitemaps ayudan a los rastreadores a encontrar páginas que los enlaces internos no alcanzan. Los límites de Google son 50 MB sin comprimir o 50 000 URL por archivo de sitemap, con URL absolutas, y puedes señalar el sitemap desde robots.txt con una línea Sitemap:.7
¿Qué suele encontrar una auditoría técnica?
Una auditoría técnica no suele encontrar un gran fallo, sino unos cuantos bloqueos pequeños y fáciles de corregir: un noindex olvidado, un canonical que apunta a la URL equivocada, una cadena de redirecciones que quedó de una migración o una sección clave que solo carga JavaScript.
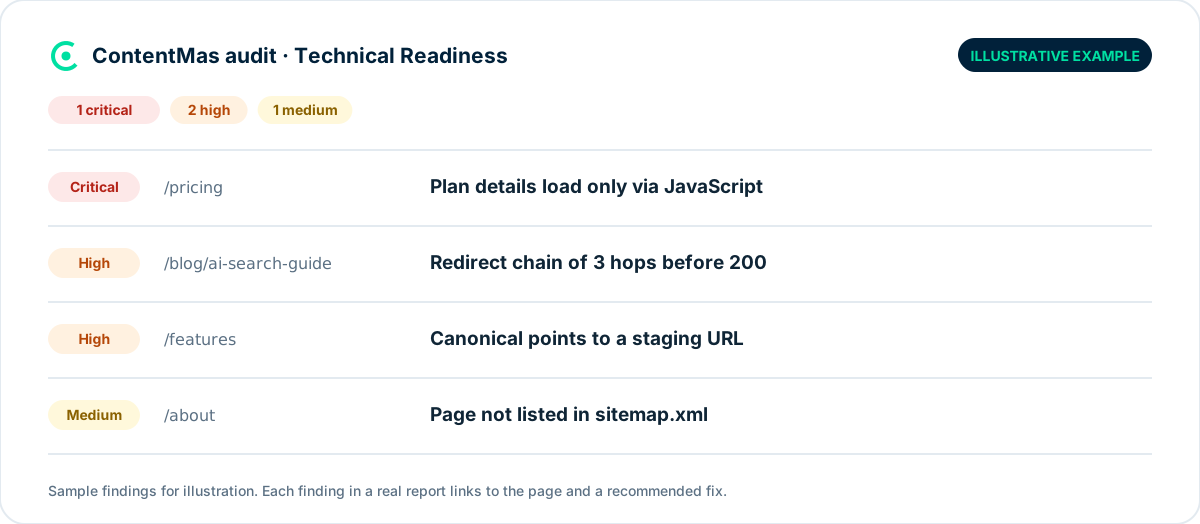
Fuente: ejemplo ilustrativo de un informe de ContentMas para una web inventada, no son datos reales. Las comprobaciones que se muestran siguen las directrices de Google Search Central.4567
Recomendamos corregir en este orden: primero todo lo que bloquea el acceso (robots.txt, reglas de la CDN, noindex, errores 4xx y 5xx), después el renderizado, luego los canonicals y las redirecciones, y por último el sitemap, la velocidad y el schema. Google señala que los errores 5xx hacen que sus rastreadores reduzcan temporalmente el ritmo,5 así que los errores del servidor cuestan tiempo de rastreo además de la página que falta.
Cómo lo comprueba ContentMas
ContentMas audita tus páginas clave con más de 600 KPI repartidos en seis pilares. El pilar de Preparación técnica analiza si los rastreadores pueden llegar a cada página y leerla: señales de rastreo e indexación, códigos de estado y redirecciones, configuración de canonical y sitemap, cuánto contenido hay en el HTML que envía el servidor, rendimiento de la página y validez de los datos estructurados.
Cada hallazgo recibe una prioridad crítica, alta, media o baja y una recomendación de corrección, para que sepas qué bloqueo eliminar primero. ContentMas mide lo preparada que está tu web. No mide con qué frecuencia te mencionan las herramientas de IA. Haz una auditoría gratuita de hasta 50 páginas o lee Cómo puntuamos para ver cómo los hallazgos se convierten en puntuaciones.
Lecturas relacionadas: How to optimize your content for ChatGPT, Perplexity, and AI Overviews · SEO frente a GEO · Seguridad web, SEO y confianza
Las guías de los seis pilares: Calidad del contenido · Confianza · Actualidad · Seguridad · SEO y GEO · Cómo puntúa ContentMas cada pilar
Preguntas frecuentes
¿Cómo sé si los rastreadores de IA pueden acceder a mi web?
Revisa robots.txt en busca de reglas que bloqueen a los bots de IA, comprueba los ajustes de bots de tu CDN y asegúrate de que tu contenido principal está en el código fuente de la página y no se carga con JavaScript. Los principales rastreadores de IA no renderizan JavaScript, así que lo que no aparece en el código fuente probablemente tampoco lo ven ellos.1
¿Bloquear GPTBot elimina mi web de la búsqueda de ChatGPT?
Por sí solo, no. OpenAI explica que OAI-SearchBot se usa para mostrar sitios en las funciones de búsqueda de ChatGPT, mientras que GPTBot sirve para el entrenamiento de modelos, y que cada ajuste es independiente de los demás.11 Nuestra guía de visibilidad en IA (en inglés) compara los principales rastreadores uno al lado del otro.
¿Necesita Google el renderizado en el servidor para indexar mi web?
No. Google renderiza JavaScript como parte del rastreo y la indexación.4 Pero aun así considera que el renderizado en el servidor o el prerrenderizado es "una gran idea", porque no todos los bots pueden ejecutar JavaScript,4 y eso incluye a la mayoría de los rastreadores de IA.1
¿Funciona una etiqueta noindex si robots.txt bloquea la página?
No. Google afirma que los ajustes de la metaetiqueta robots y de X-Robots-Tag solo se pueden leer y aplicar si los rastreadores tienen permitido acceder a la página.2 Si quieres sacar una página de la búsqueda, permite el rastreo y usa noindex.
¿Influyen las Core Web Vitals en la visibilidad en la búsqueda con IA?
Ninguna plataforma de IA que citamos publica la velocidad como requisito para usar una página como fuente. Aun así, recomendamos cumplir los umbrales de "bueno": LCP de 2,5 segundos, INP de 200 milisegundos y CLS de 0,1,10 porque las personas que hacen clic desde la búsqueda y desde las respuestas de la IA llegan a esa página.
Referencias
Cada número del artículo enlaza con su fuente más abajo.
-
Vercel — The rise of the AI crawler (se abre en una pestaña nueva), diciembre de 2024. ↩
-
Google Search Central — Robots meta tag, data-nosnippet, and X-Robots-Tag specifications (se abre en una pestaña nueva), marzo de 2026. ↩
-
HTTP Archive — Web Almanac 2024: SEO (se abre en una pestaña nueva), edición de 2024. ↩
-
Google Search Central — Understand the JavaScript SEO basics (se abre en una pestaña nueva). ↩
-
Google Search Central — How HTTP status codes, and network and DNS errors affect Google Search (se abre en una pestaña nueva), febrero de 2026. ↩
-
Google Search Central — How to specify a canonical with rel="canonical" and other methods (se abre en una pestaña nueva), julio de 2026. ↩
-
Google Search Central — Build and submit a sitemap (se abre en una pestaña nueva), julio de 2026. ↩
-
Google Search Central — General structured data guidelines (se abre en una pestaña nueva), julio de 2026. ↩
-
Cloudflare vía Business Wire — Cloudflare Just Changed How AI Crawlers Scrape the Internet-at-Large; Permission-Based Approach Makes Way for A New Business Model (se abre en una pestaña nueva), julio de 2025. ↩
-
web.dev — How the Core Web Vitals metrics thresholds were defined (se abre en una pestaña nueva), mayo de 2025. ↩
-
OpenAI — Overview of OpenAI Crawlers (se abre en una pestaña nueva). ↩
Sobre este artículo
Escrito por Nasir Ali Joiya, CEO y cofundador de ZAPTA Technologies. Revisado por el equipo de ContentMas, que desarrolla ContentMas, una herramienta de auditoría web que analiza los sitios en seis pilares para buscadores y asistentes de IA. Los datos y las cifras enlazan a sus fuentes originales en las Referencias. ¿Has visto algo desactualizado? Escríbenos y lo corregiremos.
Auditoría web gratuita
Descubre qué puntuación obtiene tu web en los buscadores y los asistentes de IA.
Una puntuación global, seis puntuaciones de pilar y una lista de correcciones priorizada en pocos minutos. Sin tarjeta de crédito.
Empezar auditoría gratuita