
Technische Bereitschaft
Können KI-Crawler Ihre Website lesen? Ein technischer Check in 10 Minuten
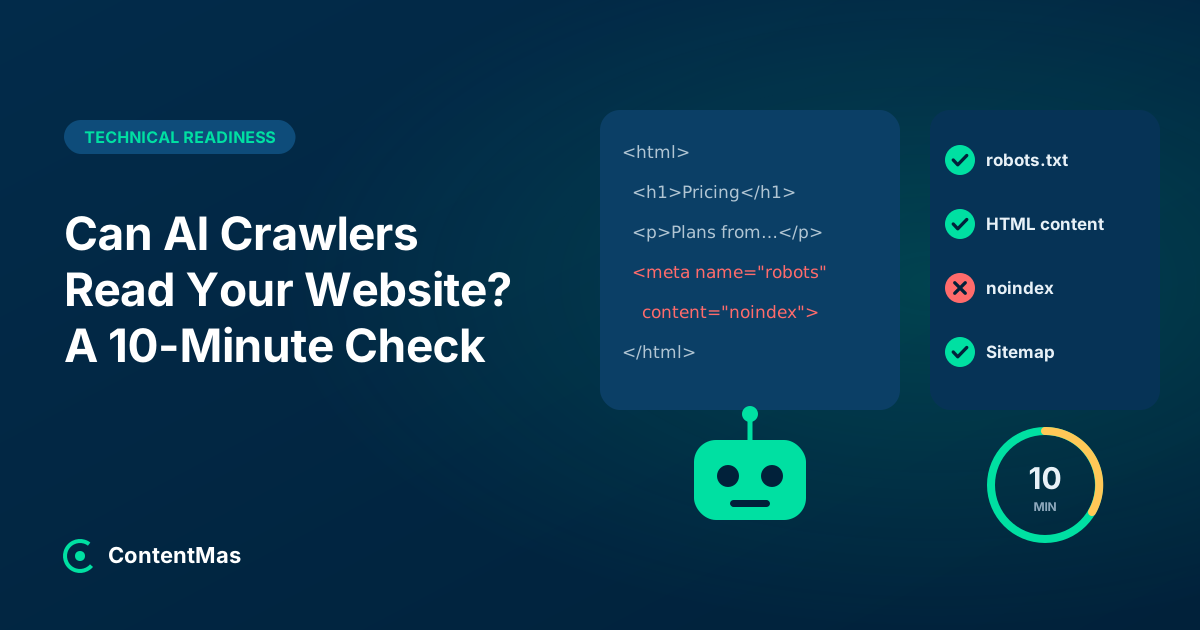
Viele KI-Crawler lesen nur das rohe HTML und halten sich an robots.txt. Prüfen Sie Zugriff, noindex, Rendering, Statuscodes, Canonicals, Sitemap, Tempo und Schema in 10 Minuten.
 Von Nasir Ali Joiya, CEO und Mitgründer von ZAPTA TechnologiesVeröffentlicht am 11 Min. Lesezeit 11 zitierte Quellen
Mit KI zusammenfassen
Wenig Zeit? Öffnen Sie diesen Artikel mit einem fertigen Prompt in Ihrem KI-Assistenten.
- ChatGPT (öffnet in einem neuen Tab mit einem Prompt zur Zusammenfassung)
- Perplexity (öffnet in einem neuen Tab mit einem Prompt zur Zusammenfassung)
- Grok (öffnet in einem neuen Tab mit einem Prompt zur Zusammenfassung)
Claude und Gemini öffnen sich mit kopiertem Prompt: Fügen Sie ihn ein, um zu starten.
Auf dieser Seite
- Warum sieht eine Website im Browser gut aus, erscheint aber nicht in der Suche oder in KI-Antworten?
- Rendern KI-Crawler JavaScript?
- Wie prüfen Sie in 10 Minuten, ob KI-Crawler Ihre Website lesen können?
- Wie sieht ein gutes Ergebnis bei jeder Prüfung aus?
- Blockiert Cloudflare KI-Crawler auf meiner Website?
- Warum sind Canonicals und Sitemaps für die KI-Suche wichtig?
- Was findet ein technisches Audit normalerweise?
- So prüft ContentMas das
- Häufig gestellte Fragen
Kurze Antwort
Kurz gesagt: vielleicht nicht, selbst wenn die Website in Ihrem Browser perfekt aussieht. Die großen KI-Crawler führen kein JavaScript aus. Inhalte, die erst nach dem Laden von Skripten erscheinen, bleiben für sie also unsichtbar,1 und eine robots.txt-Regel, ein noindex-Tag oder eine Bot-Einstellung im CDN kann sie komplett aussperren. Die acht Prüfungen unten dauern etwa zehn Minuten und zeigen, ob Suchmaschinen und KI-Assistenten Ihre Seiten tatsächlich lesen können.
Die typische Klage: „Die Website sieht gut aus, taucht aber weder bei Google noch in KI-Antworten auf.“ Ein Browser ist ein nachsichtiger Leser. Er führt jedes Skript aus, folgt jeder Weiterleitung und ignoriert robots.txt. Crawler sind strenger.
Dieser Leitfaden behandelt die Technik unter der Haube, nicht das Schreiben. Für die inhaltliche Seite lesen Sie unseren (englischsprachigen) Leitfaden How to Optimize Your Content for ChatGPT, Perplexity, and AI Overviews.
Warum sieht eine Website im Browser gut aus, erscheint aber nicht in der Suche oder in KI-Antworten?
Weil ein Crawler eine andere Version Ihrer Website sieht als Sie. Er wird vielleicht blockiert, bevor er die Seite erreicht, bekommt einen Fehlercode oder eine lange Weiterleitungskette, oder er erhält eine leere HTML-Hülle, die erst durch JavaScript zur eigentlichen Seite wird.
Nichts davon ist auf dem Bildschirm zu sehen. Eine Seite kann für Besucher schnell laden, während eine noindex-Regel Google anweist, sie aus den Suchergebnissen herauszuhalten.2 Der Web Almanac 2024 zeigt, wie verbreitet solche Signale sind: Die noindex-Regel fand sich im gerenderten HTML von 3,9 % der mobilen Seiten, und 7,40 % der mobilen Seiten fielen bei der Lighthouse-Prüfung auf eine gültige robots.txt-Datei durch.3 Manches ist Absicht, manches ein Überbleibsel aus der Staging-Umgebung.
Rendern KI-Crawler JavaScript?
Die meisten nicht. Vercel hat die großen KI-Crawler in seinem Netzwerk getestet und festgestellt, dass keiner von ihnen JavaScript rendert. Die Crawler von ChatGPT und Claude luden zwar JavaScript-Dateien herunter, führten sie aber nicht aus.1 Die Ausnahme ist Googles Gemini, denn es nutzt die Infrastruktur des Googlebot, der Seiten rendert.1
Google selbst rendert JavaScript in einem eigenen Schritt nach dem Crawling, sagt aber trotzdem, serverseitiges Rendering oder Pre-Rendering sei „immer noch eine gute Idee“, weil nicht alle Bots JavaScript ausführen können.4 Die Faustregel: Ihr Haupttext, Ihre Überschriften, Links und strukturierten Daten gehören in das HTML, das der Server ausliefert, und sollten nicht erst später per Skript hinzukommen.
Dieselbe Studie ergab, dass der Crawler von ChatGPT 34,82 % seiner Abrufe auf 404-Seiten verwendete und weitere 14,36 % auf das Folgen von Weiterleitungen, verglichen mit 8,22 % und 1,49 % beim Googlebot.1 Defekte und verschobene URLs verschwenden also viel Aufwand der KI-Crawler.
Wie prüfen Sie in 10 Minuten, ob KI-Crawler Ihre Website lesen können?
Wählen Sie Ihre Startseite und eine wichtige Unterseite, etwa die Preisseite. Jeder Schritt dauert ungefähr eine Minute.
- Lesen Sie Ihre robots.txt. Öffnen Sie
yourdomain.com/robots.txt. Suchen Sie nachDisallow: /unterUser-agent: *oder unter namentlich genannten KI-Bots. Unser Leitfaden zur KI-Sichtbarkeit erklärt, welche Crawler von OpenAI, Perplexity und Google über die Aufnahme in die Suche entscheiden und welche nur das Training steuern. - Prüfen Sie die Bot-Einstellungen Ihres CDN. Wenn Sie Cloudflare oder einen ähnlichen Dienst nutzen, öffnen Sie die Einstellungen für Bots bzw. KI-Crawler und vergewissern Sie sich, dass sie Ihrer Absicht entsprechen (siehe nächster Abschnitt).
- Suchen Sie nach
noindex. Öffnen Sie den Seitenquelltext und suchen Sie nachnoindex. Prüfen Sie dann die Response-Header (Browser-DevTools, Tab „Network“) auf einenX-Robots-Tag-Header. Google unterstützt diesen Header auch für Nicht-HTML-Dateien wie Bilder.2 - Vergleichen Sie Quelltext und gerenderte Seite. Drücken Sie Strg+U (Cmd+Option+U auf dem Mac) und suchen Sie nach einem Satz aus der Mitte Ihrer Seite. Steht er nicht im Quelltext, wird er per JavaScript geladen, und viele KI-Crawler sehen ihn nicht.1
- Prüfen Sie Statuscode und Weiterleitungen. Führen Sie
curl -I https://yourdomain.com/pageaus oder nutzen Sie einen Redirect-Checker. Ziel ist200auf der finalen URL nach höchstens einer Weiterleitung. Google indexiert keine URLs, die einen 4xx-Code liefern, und seine Crawler folgen standardmäßig bis zu 10 Weiterleitungen.5 Wir empfehlen eine einzige Weiterleitung, da andere Crawler womöglich früher aufgeben. - Prüfen Sie das Canonical-Tag. Suchen Sie im Quelltext nach
rel="canonical". Es sollte auf die eigene, saubere URL der Seite zeigen, und zwar als absolute URL, wie Google es empfiehlt.6 - Öffnen Sie Ihre Sitemap. Rufen Sie
yourdomain.com/sitemap.xmlauf und suchen Sie in der robots.txt nach einerSitemap:-Zeile. Vergewissern Sie sich, dass die wichtige Seite mit vollständiger URL aufgeführt ist.7 - Testen Sie Ladezeit und strukturierte Daten. Prüfen Sie die Seite mit PageSpeed Insights und anschließend mit Googles Test für Rich-Suchergebnisse (Rich Results Test), um Schema-Fehler aufzuspüren.8
Wenn ein Schritt fehlschlägt, beheben Sie das vor jeder Arbeit am Inhalt. Guter Inhalt hilft keiner Seite, die Crawler nicht lesen können.
Wie sieht ein gutes Ergebnis bei jeder Prüfung aus?
| Prüfung | So testen Sie es in 1 Minute | So sieht es gut aus | Tool |
|---|---|---|---|
| robots.txt | /robots.txt öffnen und die Regeln lesen | Seiten, die gefunden werden sollen, sind für Such-Crawler nicht gesperrt | Browser |
| Bot-Einstellungen im CDN | KI-Crawler-Einstellungen im CDN-Dashboard prüfen | Einstellungen entsprechen Ihrer Entscheidung; bei neuen Cloudflare-Domains wird bei der Anmeldung gefragt9 | Cloudflare-Dashboard |
| noindex / X-Robots-Tag | Quelltext nach noindex durchsuchen; Response-Header lesen | Kein noindex auf Seiten, die in die Suche sollen; die Seite ist crawlbar, damit die Regel gelesen werden kann2 | Quelltext, DevTools |
| Serverseitig gerendertes HTML | Einen Schlüsselsatz im Quelltext suchen | Haupttext, Links und Schema stehen im rohen HTML14 | Quelltext |
| Statuscodes und Weiterleitungen | curl -I auf die URL ausführen | 200 auf der finalen URL, höchstens eine Weiterleitung; nie 4xx bei aktiven Seiten5 | curl, Redirect-Checker |
| Canonical-Tag | Quelltext nach rel="canonical" durchsuchen | Eine absolute URL, die auf die bevorzugte Version zeigt6 | Quelltext |
| XML-Sitemap | /sitemap.xml öffnen | Absolute URLs, unter 50.000 URLs oder 50 MB pro Datei, in robots.txt eingetragen7 | Browser, Search Console |
| Core Web Vitals | PageSpeed Insights ausführen | LCP ≤ 2,5 s, INP ≤ 200 ms, CLS ≤ 0,1 beim 75. Perzentil10 | PageSpeed Insights |
| Strukturierte Daten | URL in den Rich Results Test einfügen | Keine Fehler; JSON-LD, das zum sichtbaren Inhalt passt8 | Rich Results Test |
Quelle: zusammengestellt von ContentMas auf Basis von Vercel, Cloudflare, Google Search Central und web.dev.1924567108
Ein Hinweis zu den Core Web Vitals: Die Schwellenwerte werden beim 75. Perzentil echter Seitenaufrufe gemessen, also müssen mindestens drei von vier Besuchen jeden Wert erreichen.10 Die Ladezeit ist keine Sperre wie robots.txt, aber langsame Seiten schaden den Besuchern, die Crawler Ihnen schicken.
Blockiert Cloudflare KI-Crawler auf meiner Website?
Möglicherweise, und vielleicht ohne dass Sie das entschieden haben. Seit Juli 2025 blockiert Cloudflare standardmäßig KI-Crawler, die ohne Erlaubnis auf Inhalte zugreifen, und fragt jede neue Domain bei der Anmeldung, ob sie zugelassen werden sollen.9
Laut Cloudflare können Kunden ihre Einstellungen jederzeit prüfen und das Crawling erlauben.9 Wenn Ihre Website hinter Cloudflare oder einem anderen CDN bzw. einer Firewall mit Bot-Regeln liegt, sollten Sie das bewusst entscheiden. Häufig wurde die Einstellung bei der Einrichtung von der Person gewählt, die das DNS konfiguriert hat, und das Marketingteam hat nie davon erfahren.
KI-Training zu blockieren ist eine legitime Entscheidung. Achten Sie nur darauf, nicht auch die Such-Crawler auszusperren, die darüber entscheiden, ob Sie in KI-Antworten erscheinen.
Warum sind Canonicals und Sitemaps für die KI-Suche wichtig?
Sie zeigen Crawlern, welche URL die richtige ist und wo Ihre wichtigen Seiten liegen. Google nennt rel="canonical" „ein starkes Signal“ dafür, welche URL kanonisch werden soll, und warnt davor, robots.txt zur Kanonisierung zu verwenden.6 Im Web Almanac 2024 hatten 65 % der mobilen Seiten ein Canonical-Tag.3
Gibt es Duplikate, etwa durch Tracking-Parameter oder regionale Kopien, liest ein Crawler womöglich die falsche Version. Unser Leitfaden Which Pages Should a Website Audit Check First? erklärt, wie sich Duplikate einschleichen.
Sitemaps helfen Crawlern, Seiten zu finden, die über interne Links nicht erreichbar sind. Google begrenzt jede Sitemap-Datei auf 50 MB unkomprimiert oder 50.000 URLs, mit absoluten URLs, und Sie können in der robots.txt mit einer Sitemap:-Zeile auf die Sitemap verweisen.7
Was findet ein technisches Audit normalerweise?
Ein technisches Audit findet meist einige kleine, behebbare Blockaden statt eines großen Totalausfalls: ein vergessenes noindex, ein Canonical, das auf die falsche URL zeigt, eine Weiterleitungskette aus einer früheren Migration oder ein wichtiger Abschnitt, der nur per JavaScript geladen wird.
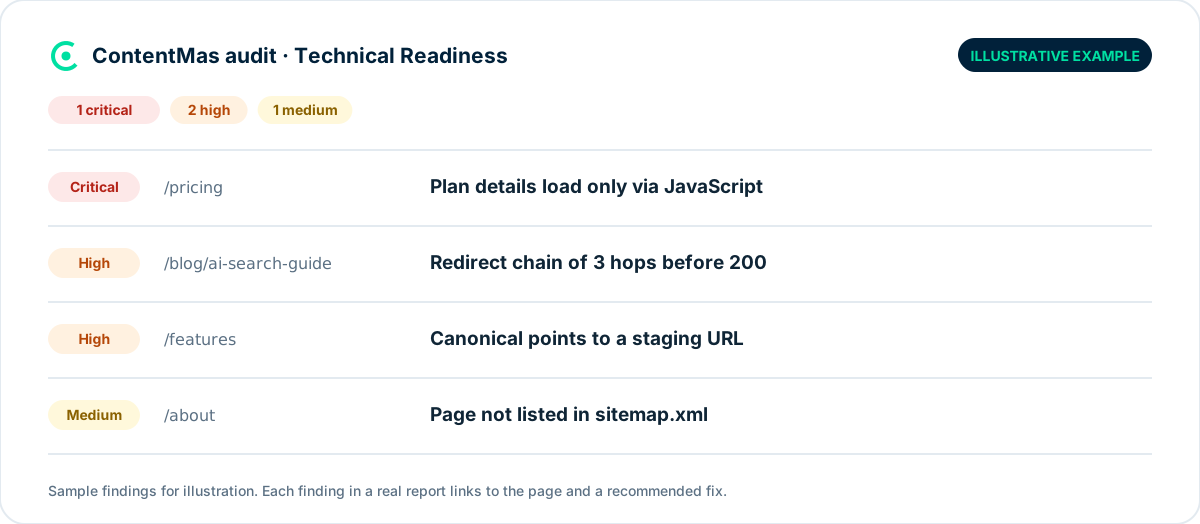
Quelle: illustratives Beispiel eines ContentMas-Berichts für eine erfundene Website, keine echten Daten. Die gezeigten Prüfungen folgen den Empfehlungen von Google Search Central.4567
Wir empfehlen diese Reihenfolge bei der Behebung: zuerst alles, was den Zugriff blockiert (robots.txt, CDN-Regeln, noindex, 4xx- und 5xx-Fehler), dann das Rendering, dann Canonicals und Weiterleitungen, dann Sitemap, Ladezeit und Schema. Google weist darauf hin, dass 5xx-Fehler seine Crawler vorübergehend bremsen,5 Serverfehler kosten also zusätzlich zur fehlenden Seite auch Crawling-Zeit.
So prüft ContentMas das
ContentMas prüft Ihre wichtigsten Seiten anhand von 600+ KPIs in sechs Säulen. Die Säule Technische Bereitschaft untersucht, ob Crawler jede Seite erreichen und lesen können: Crawling- und Indexierungssignale, Statuscodes und Weiterleitungen, Canonical- und Sitemap-Setup, wie viel Inhalt im vom Server ausgelieferten HTML steht, Seiten-Performance und die Gültigkeit der strukturierten Daten.
Jeder Befund erhält eine Priorität (kritisch, hoch, mittel oder niedrig) und eine Empfehlung zur Korrektur, damit Sie wissen, welche Blockade Sie zuerst beseitigen sollten. ContentMas misst, wie bereit Ihre Website ist. Es erfasst nicht, wie oft KI-Tools Sie erwähnen. Starten Sie ein kostenloses Audit für bis zu 50 Seiten, oder lesen Sie So bewerten wir, um zu sehen, wie aus Befunden Scores werden.
Weiterlesen: How to Optimize Your Content for ChatGPT, Perplexity, and AI Overviews · SEO vs. GEO · Website-Sicherheit, SEO und Vertrauen
Die Leitfäden zu den sechs Säulen: Qualität der Inhalte · Vertrauen · Aktualität · Sicherheit · SEO und GEO · Wie ContentMas jede Säule bewertet
Häufig gestellte Fragen
Woran erkenne ich, ob KI-Crawler auf meine Website zugreifen können?
Prüfen Sie die robots.txt auf Regeln, die KI-Bots blockieren, kontrollieren Sie die Bot-Einstellungen Ihres CDN und stellen Sie sicher, dass Ihr Hauptinhalt im Seitenquelltext steht, statt per JavaScript geladen zu werden. Die großen KI-Crawler rendern kein JavaScript. Was im Quelltext fehlt, fehlt daher sehr wahrscheinlich auch für sie.1
Verschwindet meine Website aus der ChatGPT-Suche, wenn ich GPTBot blockiere?
Nicht allein dadurch. Laut OpenAI dient OAI-SearchBot dazu, Websites in den Suchfunktionen von ChatGPT anzuzeigen, während GPTBot für das Modelltraining genutzt wird, und jede Einstellung ist von den anderen unabhängig.11 Unser Leitfaden zur KI-Sichtbarkeit vergleicht die wichtigsten Crawler direkt miteinander.
Braucht Google serverseitiges Rendering, um meine Website zu indexieren?
Nein. Google rendert JavaScript im Rahmen von Crawling und Indexierung.4 Trotzdem bezeichnet Google serverseitiges Rendering oder Pre-Rendering als „eine gute Idee“, weil nicht alle Bots JavaScript ausführen können,4 und dazu gehören die meisten KI-Crawler.1
Kann ein noindex-Tag wirken, wenn robots.txt die Seite blockiert?
Nein. Laut Google können Robots-Meta-Tags und X-Robots-Tag-Einstellungen nur gelesen und befolgt werden, wenn Crawler auf die Seite zugreifen dürfen.2 Soll eine Seite nicht in der Suche erscheinen, erlauben Sie das Crawling und verwenden Sie noindex.
Beeinflussen Core Web Vitals die Sichtbarkeit in der KI-Suche?
Keine der KI-Plattformen, die wir zitieren, nennt die Ladezeit als Kriterium dafür, als Quelle genutzt zu werden. Wir empfehlen trotzdem, die „guten“ Schwellenwerte von LCP 2,5 Sekunden, INP 200 Millisekunden und CLS 0,1 zu erreichen,10 denn die Menschen, die aus der Suche und aus KI-Antworten durchklicken, landen genau auf dieser Seite.
Quellen
Jede nummerierte Markierung im Artikel verweist auf ihre Quelle unten.
-
Vercel — The rise of the AI crawler (öffnet in einem neuen Tab), Dezember 2024. ↩
-
Google Search Central — Robots meta tag, data-nosnippet, and X-Robots-Tag specifications (öffnet in einem neuen Tab), März 2026. ↩
-
HTTP Archive — Web Almanac 2024: SEO (öffnet in einem neuen Tab), Ausgabe 2024. ↩
-
Google Search Central — Understand the JavaScript SEO basics (öffnet in einem neuen Tab). ↩
-
Google Search Central — How HTTP status codes, and network and DNS errors affect Google Search (öffnet in einem neuen Tab), Februar 2026. ↩
-
Google Search Central — How to specify a canonical with rel="canonical" and other methods (öffnet in einem neuen Tab), Juli 2026. ↩
-
Google Search Central — Build and submit a sitemap (öffnet in einem neuen Tab), Juli 2026. ↩
-
Google Search Central — General structured data guidelines (öffnet in einem neuen Tab), Juli 2026. ↩
-
Cloudflare via Business Wire — Cloudflare Just Changed How AI Crawlers Scrape the Internet-at-Large; Permission-Based Approach Makes Way for A New Business Model (öffnet in einem neuen Tab), Juli 2025. ↩
-
web.dev — How the Core Web Vitals metrics thresholds were defined (öffnet in einem neuen Tab), Mai 2025. ↩
-
OpenAI — Overview of OpenAI Crawlers (öffnet in einem neuen Tab). ↩
Über diesen Artikel
Geschrieben von Nasir Ali Joiya, CEO und Mitgründer von ZAPTA Technologies. Geprüft vom ContentMas-Team, das ContentMas entwickelt, ein Website-Audit-Tool, das Websites in sechs Säulen für Suchmaschinen und KI-Assistenten prüft. Fakten und Zahlen verlinken auf ihre Originalquellen in den Quellenangaben. Ist etwas veraltet? Schreiben Sie uns, dann korrigieren wir es.
Kostenloses Website-Audit
Sehen Sie, wie Ihre Website bei Suchmaschinen und KI-Assistenten abschneidet.
Ein Score, sechs Säulen-Scores und eine priorisierte Korrekturliste in wenigen Minuten. Ohne Kreditkarte.
Kostenloses Audit starten