
Texniki Hazırlıq
AI crawlerləri saytınızı oxuya bilirmi? 10 dəqiqəlik texniki yoxlama
Bir çox AI crawleri yalnız xam HTML-i oxuyur və robots.txt qaydalarına əməl edir. Girişi, noindex, render, status kodları, canonical, sitemap, sürət və schema-nı 10 dəqiqəyə yoxlayın.
 Müəllif: Nasir Ali Joiya, ZAPTA Technologies-in baş direktoru və həmtəsisçisiDərc olunub 10 dəq oxu 11 mənbəyə istinad
AI ilə xülasə et
Vaxtınız azdır? Bu məqaləni hazır prompt ilə AI köməkçinizdə açın.
- ChatGPT (xülasə sorğusu ilə yeni vərəqdə açılır)
- Perplexity (xülasə sorğusu ilə yeni vərəqdə açılır)
- Grok (xülasə sorğusu ilə yeni vərəqdə açılır)
Claude və Gemini prompt kopyalanmış halda açılır: başlamaq üçün onu yapışdırın.
Bu səhifədə
- Sayt niyə brauzerdə yaxşı görünür, amma axtarışda və ya AI cavablarında çıxmır?
- AI crawlerləri JavaScript-i render edirmi?
- AI crawlerlərinin saytınızı oxuya bildiyini 10 dəqiqəyə necə yoxlamaq olar?
- Hər yoxlama üçün yaxşı nəticə necə görünür?
- Cloudflare saytımda AI crawlerlərini bloklayırmı?
- Canonical və sitemap AI axtarışı üçün niyə vacibdir?
- Texniki audit adətən nə aşkar edir?
- ContentMas bunu necə yoxlayır
- Tez-tez verilən suallar
Qısa cavab
Qısaca: bəlkə də yox, hətta sayt brauzerinizdə qüsursuz görünsə belə. Əsas süni intellekt (AI) crawlerləri JavaScript-i işə salmır, ona görə də yalnız skriptlər yükləndikdən sonra görünən məzmunu onlar görmür,1 robots.txt qaydası, noindex teqi və ya CDN bot ayarı isə onların qarşısını tamamilə bağlaya bilər. Aşağıdakı səkkiz yoxlama təxminən on dəqiqə çəkir və axtarış sistemlərinin və AI assistentlərinin səhifələrinizi həqiqətən oxuya bildiyini göstərir.
Tipik şikayət belədir: «Sayt yaxşı görünür, amma nə Google-da, nə də AI cavablarında çıxmır.» Brauzer güzəştli oxucudur. O, hər skripti işə salır, hər yönləndirməni izləyir və robots.txt-yə məhəl qoymur. Crawlerlər daha sərtdir.
Bu bələdçi mətnin yazılmasından yox, texniki infrastrukturdan bəhs edir. Məzmun tərəfi üçün məzmunu ChatGPT, Perplexity və AI Overviews üçün optimallaşdırmaq haqqında bələdçimizə baxın.
Sayt niyə brauzerdə yaxşı görünür, amma axtarışda və ya AI cavablarında çıxmır?
Çünki crawler saytınızın sizin gördüyünüzdən fərqli versiyasını görür. Onun qarşısı səhifəyə çatmazdan əvvəl kəsilə bilər, o, xəta kodu və ya uzun yönləndirmə zənciri ala bilər, yaxud yalnız JavaScript işləyəndən sonra səhifəyə çevrilən boş HTML qabığı ala bilər.
Bunların heç biri ekranda görünmür. Səhifə ziyarətçilər üçün sürətlə yüklənə bilər, eyni zamanda isə noindex qaydası Google-a onu axtarış nəticələrinə daxil etməməyi bildirir.2 2024 Web Almanac bu cür siqnalların nə qədər geniş yayıldığını göstərir: noindex qaydası mobil səhifələrin 3,9%-nin render olunmuş HTML-ində var idi, mobil səhifələrin 7,40%-i isə Lighthouse-un düzgün robots.txt faylı yoxlamasından keçməmişdi.3 Bəziləri qəsdəndir, bəziləri isə test (staging) mühitindən qalan izlərdir.
AI crawlerləri JavaScript-i render edirmi?
Əksəriyyəti etmir. Vercel öz şəbəkəsində əsas AI crawlerlərini sınaqdan keçirib və onların heç birinin JavaScript-i render etmədiyini müəyyən edib. ChatGPT-nin və Claude-un crawlerləri JavaScript fayllarını yükləyib, amma işə salmayıb.1 İstisna Google-un Gemini modelidir, çünki o, səhifələri render edən Googlebot infrastrukturundan istifadə edir.1
Google özü JavaScript-i taramadan sonra ayrıca mərhələdə render edir, amma yenə də server tərəfli render və ya əvvəlcədən render etməyin «hələ də əla fikir» olduğunu deyir, çünki bütün botlar JavaScript-i işə sala bilmir.4 Praktik qayda: əsas mətniniz, başlıqlarınız, linkləriniz və strukturlaşdırılmış məlumatlarınız (schema) sonradan skriptlə əlavə edilməməli, serverin göndərdiyi HTML-də olmalıdır.
Eyni tədqiqat göstərib ki, ChatGPT-nin crawleri sorğularının 34,82%-ni 404 səhifələrinə, daha 14,36%-ni isə yönləndirmələri izləməyə sərf edib. Googlebot-da bu rəqəmlər 8,22% və 1,49% olub.1 Sınıq və köçürülmüş URL-lər AI crawlerlərinin xeyli səyini boşa çıxarır.
AI crawlerlərinin saytınızı oxuya bildiyini 10 dəqiqəyə necə yoxlamaq olar?
Ana səhifənizi və bir əsas daxili səhifəni, məsələn, qiymətlər səhifəsini seçin. Hər addım təxminən bir dəqiqə çəkir.
- robots.txt faylınızı oxuyun.
yourdomain.com/robots.txtünvanını açın.User-agent: *altında və ya adı çəkilən AI botları altındaDisallow: /olub-olmadığına baxın. AI görünürlüyü bələdçimiz hansı OpenAI, Perplexity və Google crawlerlərinin axtarışa daxil olmağı, hansılarının isə yalnız təlimi idarə etdiyini izah edir. - CDN-inizin bot ayarlarını yoxlayın. Cloudflare və ya oxşar xidmətdən istifadə edirsinizsə, onun bot və ya AI crawler ayarlarını açın və istədiyinizə uyğun olduğunu təsdiqləyin (növbəti bölməyə baxın).
noindexaxtarın. Səhifənin mənbə kodunu açın vənoindexsözünü axtarın. Sonra cavab başlıqlarında (brauzerin DevTools alətində, Network tabında)X-Robots-Tagbaşlığının olub-olmadığını yoxlayın. Google bu başlığı şəkillər kimi HTML olmayan fayllar üçün dəstəkləyir.2- Mənbə kodunu render olunmuş səhifə ilə müqayisə edin. Ctrl+U (Mac-da Cmd+Option+U) düyməsini basın və səhifənizin ortasından bir cümləni axtarın. Əgər o, mənbə kodunda yoxdursa, JavaScript ilə yüklənir və bir çox AI crawleri onu görməyəcək.1
- Status kodunu və yönləndirmələri yoxlayın.
curl -I https://yourdomain.com/pageəmrini işlədin və ya yönləndirmə yoxlayıcısından istifadə edin. Son URL-də200kodu olmalı, ən çoxu bir yönləndirmə olmalıdır. Google 4xx kodu qaytaran URL-ləri indeksləmir və onun crawlerləri standart olaraq 10-a qədər yönləndirməni izləyir.5 Biz tək yönləndirməni tövsiyə edirik, çünki digər crawlerlər daha tez dayana bilər. - Canonical teqini yoxlayın. Mənbə kodunda
rel="canonical"axtarın. O, Google-un tövsiyə etdiyi kimi, mütləq URL şəklində yazılmalı və səhifənin öz təmiz URL-ini göstərməlidir.6 - Sitemap-inizi açın.
yourdomain.com/sitemap.xmlünvanını yoxlayın və robots.txt-dəSitemap:sətrinin olub-olmadığına baxın. Vacib səhifənin tam URL ilə siyahıda olduğunu təsdiqləyin.7 - Sürəti və strukturlaşdırılmış məlumatları yoxlayın. Səhifəni PageSpeed Insights-dan, sonra schema xətalarını tapmaq üçün Google-un Rich Results Test alətindən keçirin.8
Hər hansı addım uğursuz olarsa, məzmun üzərində işə başlamazdan əvvəl onu düzəldin. Crawlerlərin oxuya bilmədiyi səhifəyə məzmun kömək edə bilməz.
Hər yoxlama üçün yaxşı nəticə necə görünür?
| Yoxlama | 1 dəqiqəyə necə test etmək olar | Yaxşı nəticə | Alət |
|---|---|---|---|
| robots.txt | /robots.txt faylını açın və qaydaları oxuyun | Tapılmasını istədiyiniz səhifələr axtarış crawlerləri üçün qadağan edilməyib | Brauzer |
| CDN bot ayarları | CDN panelinizdə AI crawler ayarlarını nəzərdən keçirin | Ayarlar seçiminizə uyğundur; yeni Cloudflare domenlərindən qeydiyyat zamanı soruşulur9 | Cloudflare paneli |
| noindex / X-Robots-Tag | Mənbə kodunda noindex axtarın; cavab başlıqlarını oxuyun | Axtarışda görmək istədiyiniz səhifələrdə noindex yoxdur; qaydanın oxunması üçün səhifə taranmağa açıqdır2 | Mənbə kodu, DevTools |
| Serverdə render olunmuş HTML | Mənbə kodunda əsas cümləni tapın | Əsas mətn, linklər və schema xam HTML-dədir14 | Mənbə kodu |
| Status kodları və yönləndirmələr | URL-i curl -I ilə yoxlayın | Son URL-də 200, ən çoxu bir yönləndirmə; işlək səhifələr üçün heç vaxt 4xx5 | curl, yönləndirmə yoxlayıcısı |
| Canonical teqi | Mənbə kodunda rel="canonical" axtarın | Üstünlük verilən versiyanı göstərən bir mütləq URL6 | Mənbə kodu |
| XML sitemap | /sitemap.xml faylını açın | Mütləq URL-lər, hər faylda 50 000 URL və ya 50 MB-dan az, robots.txt-də göstərilib7 | Brauzer, Search Console |
| Core Web Vitals | PageSpeed Insights-ı işə salın | 75-ci persentildə LCP ≤ 2,5 san, INP ≤ 200 ms, CLS ≤ 0,110 | PageSpeed Insights |
| Strukturlaşdırılmış məlumatlar | URL-i Rich Results Test alətinə yapışdırın | Xəta yoxdur; görünən məzmuna uyğun JSON-LD8 | Rich Results Test |
Mənbə: ContentMas tərəfindən Vercel, Cloudflare, Google Search Central və web.dev məlumatları əsasında tərtib edilib.1924567108
Core Web Vitals haqqında qeyd: hədlər real səhifə baxışlarının 75-ci persentilində ölçülür, yəni ziyarətlərin ən azı dörddə üçü hər bir həddə cavab verməlidir.10 Sürət robots.txt kimi maneə deyil, amma yavaş səhifələr crawlerlərin sizə göndərdiyi ziyarətçilərə zərər vurur.
Cloudflare saytımda AI crawlerlərini bloklayırmı?
Ola bilər, həm də siz bunu seçməmiş ola bilərsiniz. 2025-ci ilin iyulundan Cloudflare icazəsiz məzmuna daxil olan AI crawlerlərini standart olaraq bloklayır və hər yeni domendən qeydiyyat zamanı onlara icazə verib-verməmək barədə soruşur.9
Cloudflare deyir ki, müştərilər istənilən vaxt ayarlarını yoxlaya və taramaya icazə verə bilərlər.9 Saytınız Cloudflare və ya bot qaydaları olan hər hansı CDN ya da firewall arxasındadırsa, bunu düşünülmüş qərara çevirin. Tez-tez rast gəlinən hal belədir: ayarı quraşdırma zamanı DNS-i tənzimləyən şəxs seçib, marketinq komandası isə bundan heç xəbər tutmayıb.
AI təlimini bloklamaq düzgün seçim ola bilər. Sadəcə əmin olun ki, AI cavablarında görünüb-görünməyəcəyinizi müəyyən edən axtarış crawlerlərini də bloklamırsınız.
Canonical və sitemap AI axtarışı üçün niyə vacibdir?
Onlar crawlerlərə hansı URL-in əsl URL olduğunu və vacib səhifələrinizin harada yerləşdiyini bildirir. Google rel="canonical" atributunu hansı URL-in canonical olacağı barədə «güclü siqnal» adlandırır və canonical təyin etmək üçün robots.txt-dən istifadə etməməyi tövsiyə edir.6 2024 Web Almanac məlumatına görə, mobil səhifələrin 65%-ində canonical teqi var idi.3
Dublikatlar olduqda, məsələn, izləmə parametrləri və ya regional nüsxələr, crawler yanlış versiyanı oxuya bilər. Əvvəlcə hansı səhifələri audit etməli bələdçimiz dublikatların necə yarandığını izah edir.
Sitemap-lər crawlerlərə daxili linklərin buraxdığı səhifələri tapmağa kömək edir. Google-un limitləri hər sitemap faylı üçün sıxılmamış halda 50 MB və ya 50 000 URL-dir, URL-lər mütləq olmalıdır, sitemap-i isə robots.txt-də Sitemap: sətri ilə göstərə bilərsiniz.7
Texniki audit adətən nə aşkar edir?
Texniki audit adətən bir böyük uğursuzluq deyil, bir neçə kiçik, düzəldilə bilən maneə aşkar edir: unudulmuş noindex, yanlış URL-ə işarə edən canonical, miqrasiyadan qalmış yönləndirmə zənciri və ya yalnız JavaScript ilə yüklənən əsas bölmə.
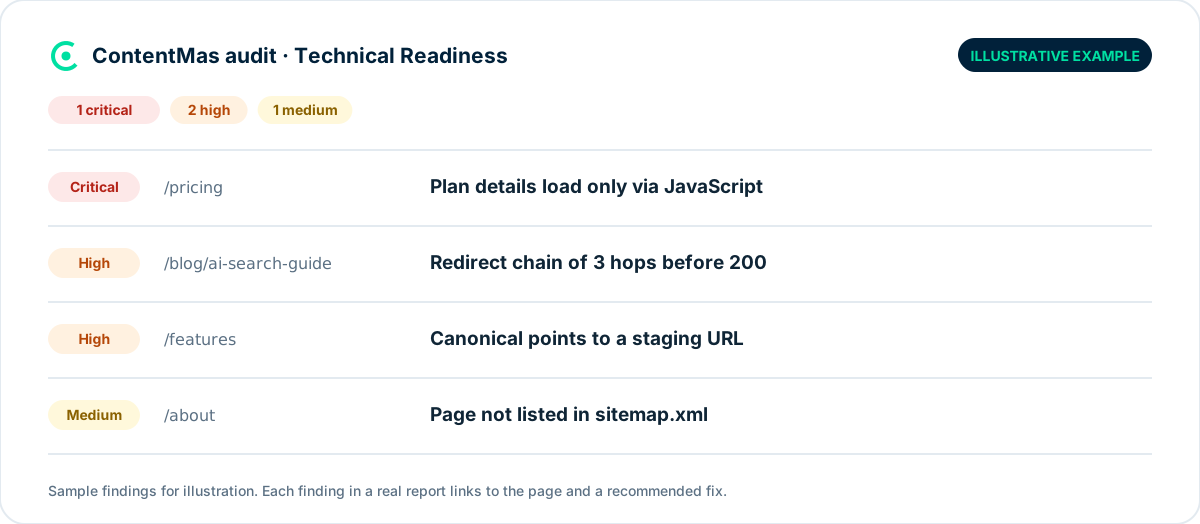
Mənbə: uydurma sayt üçün ContentMas hesabatının illüstrativ nümunəsidir, real məlumat deyil. Göstərilən yoxlamalar Google Search Central təlimatlarına əsaslanır.4567
Düzəlişləri bu ardıcıllıqla etməyi tövsiyə edirik: əvvəlcə girişi bloklayan hər şey (robots.txt, CDN qaydaları, noindex, 4xx və 5xx xətaları), sonra render, sonra canonical və yönləndirmələr, ən sonda isə sitemap, sürət və schema. Google qeyd edir ki, 5xx xətaları onun crawlerlərinin müvəqqəti yavaşlamasına səbəb olur,5 yəni server xətaları itən səhifədən əlavə tarama vaxtı da aparır.
ContentMas bunu necə yoxlayır
ContentMas əsas səhifələrinizi altı sütun üzrə 600+ KPI əsasında audit edir. Texniki hazırlıq sütunu crawlerlərin hər səhifəyə çata və onu oxuya bildiyini yoxlayır: tarama və indeksləmə siqnalları, status kodları və yönləndirmələr, canonical və sitemap quraşdırması, məzmunun nə qədərinin serverin göndərdiyi HTML-də olduğu, səhifə performansı və strukturlaşdırılmış məlumatların düzgünlüyü.
Hər tapıntı kritik, yüksək, orta və ya aşağı prioritet və düzəliş tövsiyəsi alır, beləliklə əvvəlcə hansı maneəni aradan qaldırmalı olduğunuzu bilirsiniz. ContentMas saytınızın hazırlığını ölçür. O, AI alətlərinin sizi nə qədər tez-tez xatırlatdığını izləmir. 50 səhifəyə qədər pulsuz audit keçirin və ya tapıntıların necə bala çevrildiyini görmək üçün Necə qiymətləndiririk səhifəsini oxuyun.
Əlaqəli məqalələr: Məzmununuzu ChatGPT, Perplexity və AI Overviews üçün necə optimallaşdırmalı · SEO və GEO · Veb sayt təhlükəsizliyi, SEO və etibar
Altı sütun üzrə bələdçilər: Məzmun keyfiyyəti · Etibar · Aktuallıq · Təhlükəsizlik · SEO və GEO · ContentMas hər sütunu necə qiymətləndirir
Tez-tez verilən suallar
AI crawlerlərinin saytıma daxil ola bildiyini necə bilə bilərəm?
robots.txt faylında AI botlarını bloklayan qaydaları yoxlayın, CDN-inizin bot ayarlarını nəzərdən keçirin və əsas məzmununuzun JavaScript ilə yüklənmədiyinə, səhifənin mənbə kodunda olduğuna əmin olun. Əsas AI crawlerləri JavaScript-i render etmir, ona görə də mənbə kodunda olmayan məzmun, çox güman ki, onlar üçün də yoxdur.1
GPTBot-u bloklamaq saytımı ChatGPT axtarışından çıxarırmı?
Təkbaşına yox. OpenAI bildirir ki, OAI-SearchBot saytları ChatGPT-nin axtarış funksiyalarında göstərmək üçün, GPTBot isə model təlimi üçün istifadə olunur və hər ayar digərlərindən asılı deyil.11 AI görünürlüyü bələdçimiz əsas crawlerləri yan-yana müqayisə edir.
Google saytımı indeksləmək üçün server tərəfli renderə ehtiyac duyurmu?
Xeyr. Google JavaScript-i tarama və indeksləmə prosesinin bir hissəsi kimi render edir.4 Amma Google yenə də server tərəfli və ya əvvəlcədən renderi «əla fikir» adlandırır, çünki bütün botlar JavaScript-i işə sala bilmir,4 bura əksər AI crawlerləri də daxildir.1
robots.txt səhifəni bloklayırsa, noindex teqi işləyə bilərmi?
Xeyr. Google bildirir ki, robots meta və X-Robots-Tag ayarları yalnız crawlerlərin səhifəyə daxil olmasına icazə verildikdə oxuna və icra oluna bilər.2 Səhifəni axtarışdan çıxarmaq istəyirsinizsə, taramaya icazə verin və noindex istifadə edin.
Core Web Vitals AI axtarışında görünürlüyə təsir edirmi?
İstinad etdiyimiz heç bir AI platforması sürəti mənbə kimi istifadə olunmaq üçün qayda kimi dərc etmir. Biz yenə də LCP 2,5 saniyə, INP 200 millisaniyə və CLS 0,1 «yaxşı» hədlərinə cavab verməyi tövsiyə edirik,10 çünki axtarışdan və AI cavablarından keçid edən insanlar məhz həmin səhifəyə düşür.
İstinadlar
Məqalədəki hər nömrəli işarə aşağıdakı mənbəyə keçid verir.
Mənbələr
-
Vercel — The rise of the AI crawler (yeni vərəqdə açılır), dekabr 2024. ↩
-
Google Search Central — Robots meta tag, data-nosnippet, and X-Robots-Tag specifications (yeni vərəqdə açılır), mart 2026. ↩
-
HTTP Archive — Web Almanac 2024: SEO (yeni vərəqdə açılır), 2024-cü il nəşri. ↩
-
Google Search Central — Understand the JavaScript SEO basics (yeni vərəqdə açılır). ↩
-
Google Search Central — How HTTP status codes, and network and DNS errors affect Google Search (yeni vərəqdə açılır), fevral 2026. ↩
-
Google Search Central — How to specify a canonical with rel="canonical" and other methods (yeni vərəqdə açılır), iyul 2026. ↩
-
Google Search Central — Build and submit a sitemap (yeni vərəqdə açılır), iyul 2026. ↩
-
Google Search Central — General structured data guidelines (yeni vərəqdə açılır), iyul 2026. ↩
-
Cloudflare via Business Wire — Cloudflare Just Changed How AI Crawlers Scrape the Internet-at-Large; Permission-Based Approach Makes Way for A New Business Model (yeni vərəqdə açılır), iyul 2025. ↩
-
web.dev — How the Core Web Vitals metrics thresholds were defined (yeni vərəqdə açılır), may 2025. ↩
-
OpenAI — Overview of OpenAI Crawlers (yeni vərəqdə açılır). ↩
Bu məqalə haqqında
Müəllif: Nasir Ali Joiya, ZAPTA Technologies-in baş direktoru və həmtəsisçisi. Məqaləni axtarış sistemləri və AI köməkçiləri üçün saytları altı sütun üzrə yoxlayan veb sayt audit aləti ContentMas-ı quran ContentMas komandası yoxlayıb. Faktlar və rəqəmlər Mənbələr bölməsindəki orijinal mənbələrə keçid verir. Köhnəlmiş bir şey gördünüz? Bizə yazın, düzəldək.
Pulsuz veb sayt auditi
Saytınızın axtarış sistemləri və AI köməkçiləri üçün balını görün.
Bir neçə dəqiqəyə bir bal, altı sütun balı və sıralanmış düzəliş siyahısı. Kredit kartı tələb olunmur.
Pulsuz auditə başla