
Texniki Hazırlıq
Saytınız AI crawlerlərini bloklayır? 10 dəqiqəlik yoxlama
Sayt AI crawlerlərini robots.txt-də, CDN-in bot ayarlarında və ya firewall-da bloklaya bilər, çox vaxt heç kim bu qərarı vermədən. 10 dəqiqə çəkən üç yoxlama.
 Müəllif: Nasir Ali Joiya, ZAPTA Technologies-in baş direktoru və həmtəsisçisiDərc olunub 14 dəq oxu 10 mənbəyə istinad
AI ilə xülasə et
Vaxtınız azdır? Bu məqaləni hazır prompt ilə AI köməkçinizdə açın.
- ChatGPT (xülasə sorğusu ilə yeni vərəqdə açılır)
- Perplexity (xülasə sorğusu ilə yeni vərəqdə açılır)
- Grok (xülasə sorğusu ilə yeni vərəqdə açılır)
Claude və Gemini prompt kopyalanmış halda açılır: başlamaq üçün onu yapışdırın.
Bu səhifədə
- Sayt AI crawlerlərini harada bloklaya bilər?
- Sizə istinad veriləcəyinə hansı AI crawlerləri qərar verir?
- Addım 1: Robots.txt faylınız əslində nə deyir? (3 dəqiqə)
- Addım 2: CDN-iniz sizin əvəzinizə nəyə qərar verib? (3 dəqiqə)
- Addım 3: Firewall-unuz crawleri buraxır? (3 dəqiqə)
- Nəyə icazə verməli, nəyi bloklamalı?
- ContentMas AI crawlerlərinin bloklanmasında necə kömək edir?
- Əsas nəticələr
- Tez-tez verilən suallar
Qısa cavab
Qısaca: AI crawlerlərinin bloklanması üç yerdə baş verə bilər: robots.txt faylında, CDN-in bot ayarlarında və serverin firewall-unda və ya təhlükəsizlik plaginində; sahiblərin əksəriyyəti isə yalnız birincini yoxlayır. Ayarları çox vaxt siz yox, hostinq və ya standart parametr seçib: Cloudflare indi yeni domenə reklam göstərib-göstərməməsindən asılı olaraq iki hazır profildən birini verir və 2026-cı ilin sentyabrında köhnə "Block AI Bots" (AI botlarını blokla) ayarı olan bütün domenləri yeni qaydalara keçirib,1 Google-un AI funksiyalarında görünmək üçün öz məsləhəti isə "robots.txt-də, həmçinin istənilən CDN və ya hostinq infrastrukturu tərəfindən crawl-a icazə verildiyindən" əmin olmaqdır.2 Hər AI şirkəti təlim, axtarış və istifadəçi sorğuları üçün ayrı crawlerlər işlədir və hər birinin öz açarı var,3 ona görə yoxlama sizə istinad veriləcəyinə qərar verən crawlerlərin başqa məqsəd üçün yazılmış qaydaya ilişmədiyini təsdiqləyir. Aşağıdakı üç addım təxminən on dəqiqə çəkir.
Siz AI köməkçilərinin ziyarətçi göndərdiyini oxuyursunuz, yoxlayırsınız və saytınız heç vaxt görünmür. Robots.txt zərərsiz görünür, nəticə isə "məzmunumuz kifayət qədər yaxşı deyil" olur.
Çox vaxt crawler heç içəri girə bilməyib. Qeydiyyat zamanı seçilmiş CDN açarı, "pis botları" istifadəçi agentinə görə bloklayan təhlükəsizlik plagini və ya sürətlə sorğu göndərən hər şeyə 403 qaytaran sürət limiti ChatGPT, Claude, Perplexity və Google-un axtarış crawlerlərini robots.txt-də bircə sətir olmadan kənarda saxlaya bilər.
Bu bələdçi yalnız girişi əhatə edir. Crawlerin tapdığını oxuya bilib-bilməməsi (JavaScript, noindex, yönləndirmələr) 10 dəqiqəlik texniki yoxlamanın mövzusudur.
Sayt AI crawlerlərini harada bloklaya bilər?
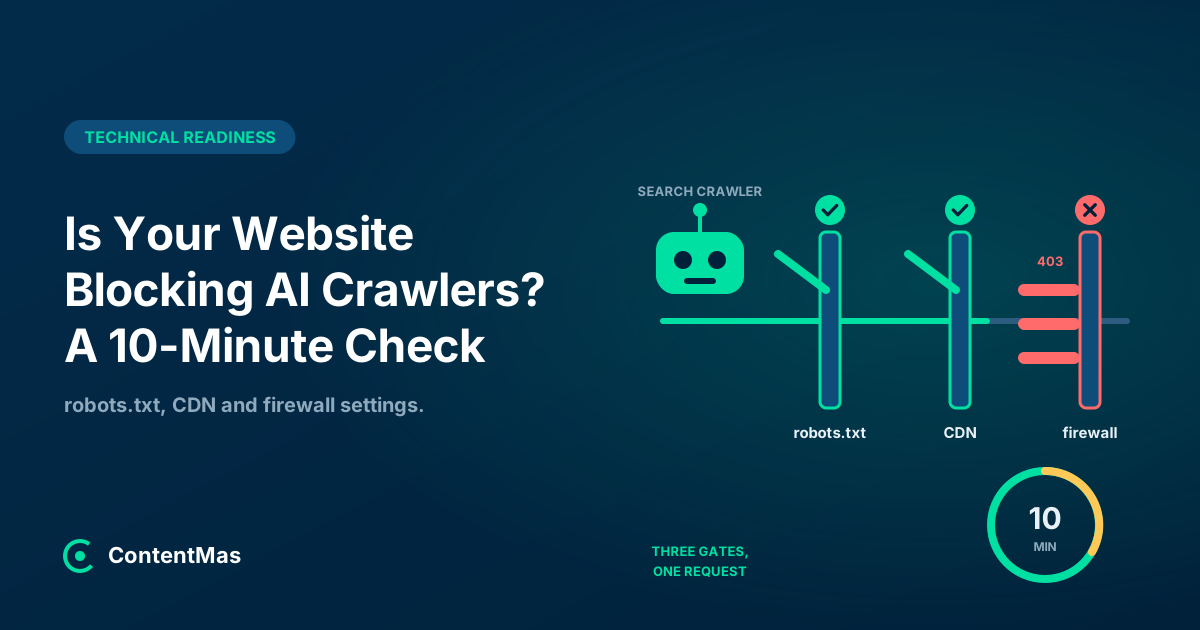
Üç qatda, və crawler hər üçündən keçməlidir. Birincisi tövsiyə xarakterlidir, digər ikisi məcburi tətbiq olunur.
| Qat | Nə edir | Adətən kim qurub | Bloklanmış crawler bunu necə görür |
|---|---|---|---|
| robots.txt | Crawlerlərdən müəyyən yollara və ya bütün sayta girməməyi xahiş edir | Developer, SEO plagini və ya sizin adınızdan CDN | Qaydanı oxuyur və gedir (əməl edirsə) |
| CDN bot ayarları (Cloudflare, Vercel və digərləri) | Sorğuları serverinizə çatmazdan əvvəl bot kateqoriyasına görə bloklayır və ya yoxlama səhifəsi göstərir | DNS-i quran şəxs və ya qeydiyyatdakı standart ayar | 403, yoxlama (challenge) səhifəsi və ya kəsilmiş bağlantı |
| Firewall, WAF, təhlükəsizlik plagini, sürət limitləri | Serverdə istifadəçi agentinə, IP aralığına və ya sorğu sürətinə görə bloklayır | Hostinq provayderi və ya təhlükəsizlik plagini | 403, 401, 429 və ya timeout |
Birinci qat dizaynına görə könüllüdür. Səhifəni bir şəxs istədiyi üçün yükləyən crawlerlər bunu öz sənədlərində açıq deyir: OpenAI ChatGPT-User haqqında qeyd edir ki, "Bu hərəkətlər istifadəçi tərəfindən başladıldığı üçün robots.txt qaydaları tətbiq olunmaya bilər,"3 Perplexity isə Perplexity-User haqqında deyir ki, "Yükləməni istifadəçi istədiyi üçün bu fetcher adətən robots.txt qaydalarına məhəl qoymur."4 İkinci və üçüncü qatlar saytların istəmədən bloklandığı yerdir, çünki oradakı qaydalar ümumiyyətlə "botlar" üçün yazılıb.
Robots.txt-nin dediyi ilə serverin etdiyi iki fərqli şeydir, həm də hər iki istiqamətdə. Yoxlama hər ikisini əhatə etməlidir.
Sizə istinad veriləcəyinə hansı AI crawlerləri qərar verir?
Axtarış və istifadəçi crawlerləri, təlim crawlerləri yox. Hər böyük AI şirkəti trafikini ayrı istifadəçi agentlərinə bölür və hər birinin öz ayarı var.
| Şirkət | Təlim crawleri | Axtarış və ya indeks crawleri | İstifadəçi tərəfindən işə salınan fetcher | Sənədlər nə deyir |
|---|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User | "Hər ayar digərlərindən müstəqildir"; OAI-SearchBot-dan imtina edən saytlar "ChatGPT axtarış cavablarında göstərilməyəcək"3 |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User | Claude-SearchBot-u söndürmək "saytınızın istifadəçi axtarış nəticələrindəki görünürlüyünü və dəqiqliyini azalda bilər"6 |
| Perplexity | Heç biri göstərilməyib; PerplexityBot "AI fundamental modelləri üçün məzmun toplamaq məqsədilə istifadə olunmur" | PerplexityBot | Perplexity-User | PerplexityBot-a və onun dərc olunmuş IP aralıqlarına icazə verməyi tövsiyə edir4 |
| Google-Extended (yalnız robots.txt tokeni) | Googlebot | Burada əhatə olunmur | Googlebot üçün robots.txt qaydaları AI Overviews və AI Mode üçün "idarəetmə vasitəsidir"2; Google-Extended "saytın Google Axtarışa daxil edilməsinə təsir etmir"7 |
Yoxlama üçün iki detal vacibdir. Birincisi, OAI-SearchBot-dan imtina edən sayt "yenə də naviqasiya linkləri kimi görünə bilər," amma axtarış cavablarında yox,3 ona görə səhv bota qoyulmuş blok loqlarınızda blok kimi görünmür: trafik sadəcə heç gəlmir. İkincisi, Google-Extended-in "ayrıca HTTP sorğusu istifadəçi agenti sətri yoxdur"; "robots.txt istifadəçi agenti tokeni idarəetmə məqsədilə istifadə olunur."7 Firewall qaydası ona heç vaxt uyğun gələ bilməz, onun üçün yazılmış robots.txt qaydası isə Axtarışda heç nəyi dəyişmir: yalnız Google-un səhifələrinizi Gemini modellərinin təlimi və əsaslandırılması üçün istifadə edib-etməyəcəyini idarə edir.7
Təlim crawlerlərini bloklamaq qanuni seçimdir. Səhv GPTBot və ya "AI botları" üçün yazılmış, amma səssizcə OAI-SearchBot, Claude-SearchBot və PerplexityBot-u da tutan qaydadır.
Addım 1: Robots.txt faylınız əslində nə deyir? (3 dəqiqə)
yourdomain.com/robots.txt ünvanını brauzerdə açın, sonra crawlerin aldığı status kodunu görmək üçün onu komanda sətrindən yükləyin:
curl -s -o /dev/null -w "%{http_code}\n" https://yourdomain.com/robots.txt
curl -s https://yourdomain.com/robots.txt
Dörd şeyə baxın.
1. Ümumi qaydalar
User-agent: * və ardınca Disallow: / ona əməl edən hər crawleri, axtarış sistemləri də daxil olmaqla, bloklayır. Adı göstərilmiş AI botunun altındakı Disallow: / yalnız həmin botu bloklayır. Hər User-agent blokunu oxuyun: GPTBot üçün qayda, əgər bunu nəzərdə tutmusunuzsa, qaydasındadır; OAI-SearchBot və ya PerplexityBot üçün qayda isə istinad almaqdan imtina etdiyiniz deməkdir.
2. Sizin yazmadığınız sətirlər
CDN-iniz bu fayla sətir əlavə edə və ondan sətir çıxara bilər. HasData 2026-cı ilin iyulunda Cloudflare arxasındakı 118 saytın arxivlənmiş robots.txt-sində AI imtina direktivi tapdı, 2026-cı il 16 sentyabrda isə həmin saytların heç birində tapmadı; Cloudflare arxasındakı saytlar arasında GPTBot-u qadağan edənlərin payı iki snapşot arasında 17.1%-dən 9.9%-ə düşdü, Cloudflare arxasında olmayan saytlarda isə 18.7%-dən 18.6%-ə.5 Heç vaxt redaktə etmədiyiniz sətir peyda olursa və ya yox olursa, onu yaradan ayar faylda yox, CDN panelindədir.
3. Status kodu
Google "429 istisna olmaqla bütün 4xx xətalarına etibarlı robots.txt faylı yoxmuş kimi" baxır, ona görə faylın olmaması heç bir məhdudiyyət olmaması deməkdir.8 5xx isə əksinədir: "İlk 12 saat ərzində Google saytı crawl etməyi dayandırır, amma robots.txt faylını yükləməyə cəhd etməyə davam edir," sonra 30 günə qədər sonuncu işlək versiyadan istifadə edir.8 Firewall qaydasına görə vaxtı bitən və ya server xətası qaytaran robots.txt bütün sayt üzrə crawl dayanması deməkdir və brauzerinizdə normal fayl kimi görünür.
4. Dəyişiklik nə qədər vaxt aparır
Google "robots.txt faylının məzmununu adətən 24 saata qədər keşdə saxlayır."8 OpenAI deyir ki, axtarış üçün "saytın robots.txt yeniləməsindən sistemlərimizin uyğunlaşmasına ~24 saat çəkə bilər,"3 Perplexity isə dəyişikliklərin əks olunmasının "24 saata qədər" çəkə biləcəyini bildirir.4 Faylı düzəldin, sonra nəticəyə qiymət verməzdən əvvəl bir gün gözləyin.
Addım 2: CDN-iniz sizin əvəzinizə nəyə qərar verib? (3 dəqiqə)
CDN panelinizin bot və ya AI crawler bölməsini açın və hər kateqoriyanın cari vəziyyətini oxuyun. Sizsiz qərar verilmiş ən ehtimal olunan yer buradır.
Cloudflare
Cloudflare bir kliklik "Block AI Bots" açarını üç siyasətlə əvəz etdi: "Search - axtarış indeksi qurmaq üçün crawl," "Training - modeli öyrətmək və ya dəqiqləşdirmək üçün crawl" və "Agent - insanın adından səhifəyə daxil olan, istifadəçinin yönləndirdiyi agentlər."1 2026-cı il 15 sentyabrdan yeni domenə iki hazır profildən biri təklif olunur. "Reklamla pul qazanmayan" saytda Search, Training və Agent üçü də Allow (icazə ver) olur; "reklamla pul qazanan" saytda Search Allow, Training "Disallow AI Training" (AI təlimini qadağan et) və Agent "Block on pages with ads" (reklamlı səhifələrdə blokla) olur.1
Mövcud müştərilər köçürüldü. Qranular idarəetmələrə heç vaxt toxunmamış və köhnə "Block AI Bots" açarı aktiv olan domendə indi Search Allow, Training Disallow AI Training və Agent Block on pages with ads var.1 Bu, 2025-ci ildə açarı aktiv edib sonra ChatGPT-nin niyə istinad etməyi dayandırdığını düşünən hər kəs üçün yaxşı xəbərdir: axtarış crawl-ına yenidən icazə verilib. Amma Search sətrini özünüz oxuyun, çünki "Block və Block on pages with ads indi Applebot, Bingbot və Googlebot daxil olmaqla qarışıq istifadəli crawlerlərə də tətbiq olunur," ona görə "hər iki ayar təlimlə yanaşı axtarışa da təsir edir."1 Search-də Block sizi Google-dan da gizlədir. Axtarışı saxlayıb təlimi dayandırmaq üçün ayar Disallow AI Training-dir: "Disallow AI Training altında onlar saytınızı axtarış üçün crawl etməyə davam edə bilər."1
Vercel
Vercel-in AI Bots Managed Ruleset-i "standart olaraq qeyri-aktivdir," Allow kimi göstərilir və "AI Crawlers və ya AI Assistants kateqoriyalarını bir-birindən müstəqil bloklamağa" imkan verir.9 Kateqoriyalar dəqiqdir: "AI Crawlers: təlim üçün məzmunu crawl edən və toplayan botlar" və "AI Assistants: istifadəçi hərəkətlərinə cavab olaraq səhifələri yükləyən və ya axtarış sorğuları üçün istifadə edən botlar."9 AI Assistants-a Deny (rədd et) qoymaq "həmin kateqoriya üzrə AI botlarından gəldiyi müəyyən edilən bütün trafiki bloklayır,"9 bu isə məhz sizə lazım olan axtarış trafikidir. Yalnız AI Crawlers-ə Deny isə təkcə təlimdən imtinadır.
Digər CDN-lər və hostinqlər
Eyni iki sual hər yerdə keçərlidir: axtarış və ya köməkçi crawlerlərini əhatə edən bot kateqoriyası varmı və onun hərəkəti nədir? Panel yalnız tək açar kimi "AI botlarını blokla" təklif edirsə, vendorun sənədləri əksini deyənə qədər onun axtarış crawlerlərini də blokladığını fərz edin.
Addım 3: Firewall-unuz crawleri buraxır? (3 dəqiqə)
Ana səhifənizi iki dəfə yükləyin: bir dəfə brauzer kimi, bir dəfə real AI crawlerinin istifadəçi agenti ilə, və status kodlarını müqayisə edin.
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36" https://yourdomain.com/
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot" https://yourdomain.com/
İkinci sətir OAI-SearchBot-un dərc olunmuş istifadəçi agentidir;3 PerplexityBot/1.04 və ClaudeBot6 ilə təkrarlayın. Hər iki sorğu 200 qaytarmalıdır. Crawler sorğusu 403, 401 və ya 429, yaxud yoxlama səhifəsi qaytarırsa, serverdə və ya WAF-da nəsə istifadəçi agentinə uyğun gəlir. Bu, HasData-nın geniş miqyasda apardığı, naşir saytlarında brauzerlərlə GPTBot arasında 30 ballıq fərqi tapan testdir.5
Axtarış üçün üçünün ən pisi 403-dür, çünki crawlerlər onu "məzmun mövcud deyil" kimi oxuyur. Google birbaşa deyir: "Google 4xx status kodu qaytaran URL-lərin məzmunundan istifadə etmir," və "URL əvvəllər indekslənibsə, indeksləmə sistemi onu indeksdən çıxarır."10 Həmçinin xəbərdarlıq edir: "Crawl sürətini məhdudlaşdırmaq üçün 401 və 403 status kodlarından istifadə etməyin."10 429 və ya 5xx isə həddindən artıq yük kimi oxunur: bu xətalar "Google-un crawlerlərini crawl-ı müvəqqəti yavaşlatmağa sövq edir," artıq indekslənmiş URL-lər isə "indeksdə saxlanılır, amma sonda çıxarılır."10 İstənilən istifadəçi agentində "bot" sözünə uyğun gələn geniş qayda bunu Googlebot və Bingbot-a da edir.
Test uğursuz olanda baxılası üç yer:
- WAF və ya təhlükəsizlik plagini. Qaydalarında "user agent," "bad bots," "AI bots" və "crawler" axtarın. Plaginin blokladığı istifadəçi agentləri siyahısı varsa, onu açın və hər hansı AI axtarış sistemi crawlerinin orada olub-olmadığını yoxlayın.
- Sürət limiti. Crawlerlər qısa vaxtda çoxlu səhifə yükləyir. Limit
429əvəzinə403qaytarırsa, toxunduğu hər səhifə yox olmuş sayılır.10 - IP blokları. OpenAI, Anthropic və Perplexity crawlerlərinin istifadə etdiyi IP aralıqlarını dərc edir, ona görə crawlerin əsl olduğunu istifadəçi agentindən təxmin etmək əvəzinə yoxlaya bilərsiniz;364 Perplexity qeyd edir ki, "Hər botun öz IP aralıqları var, ona görə hər User-Agent-i öz IP aralıqları ilə tutuşdurun."4 Siyahılardan icazə vermək üçün istifadə edin, imtina vasitəsi kimi yox: Anthropic xəbərdarlıq edir ki, onun IP ünvanlarını bloklamaq "düzgün işləməyə və ya imtinanı davamlı şəkildə təmin etməyə bilər, çünki bu, robots.txt faylınızı oxumaq imkanımıza mane olur."6
Nəyə icazə verməli, nəyi bloklamalı?
Şirkətə görə yox, məqsədə görə qərar verin. Axtarış və istifadəçi crawlerləri sizə istinad qazandırır; təlim isə hər vendorda ayrı açarı olan ayrı məsələdir.3647
| Məqsəd | robots.txt | CDN | Firewall |
|---|---|---|---|
| AI köməkçilərindən istinad almaq və Google-u saxlamaq | OAI-SearchBot, Claude-SearchBot, PerplexityBot və Googlebot-a icazə verin | Search və ya Assistants kateqoriyası Allow olsun | Heç bir istifadəçi agenti və ya sürət qaydası onlara 403 qaytarmasın |
| Bunu saxlayıb model təlimindən imtina etmək | GPTBot, ClaudeBot və Google-Extended üçün Disallow: / əlavə edin | Training Disallow AI Training (Cloudflare) və ya AI Crawlers-də Deny (Vercel) olsun | Əlavə heç nə |
| AI cavablarından tamamilə kənarda qalmaq | Axtarış crawlerlərini də qadağan edin | Search və ya Assistants kateqoriyasını bloklayın | İstəyə görə, robots.txt-yə məhəl qoymayan crawlerlər üçün |
Yalnız üçüncü sətir AI axtarış sistemlərində görünürlüyə başa gəlir. İkinci sətir pulsuzdur: Google deyir ki, Google-Extended "Google Axtarışda sıralama siqnalı kimi istifadə olunmur,"7 OpenAI isə deyir ki, sayt "axtarış nəticələrində görünmək üçün OAI-SearchBot-a icazə verib GPTBot-u qadağan edə bilər."3
ContentMas AI crawlerlərinin bloklanmasında necə kömək edir?
ContentMas süni intellektlə işləyən SEO alətidir: saytınızı Google və AI axtarış sistemləri üçün audit edir və daha yüksək sıralanmaq və istinad almaq üçün nəyi düzəltməli olduğunuzu dəqiq göstərir. Onun Texniki Hazırlıq yoxlamaları crawlerlərin hər səhifəyə çata və onu oxuya bilib-bilmədiyinə baxır: axtarış və AI crawlerlərinə tətbiq olunan robots.txt qaydaları, faylın və səhifələrin qaytardığı status kodu, yönləndirmələr və məzmunun nə qədərinin serverin göndərdiyi HTML-də olması. SEO və GEO Hazırlığı sütunu (Google və AI axtarış sistemlərində görünürlük; GEO Generative Engine Optimization deməkdir) keçən səhifələrin tapıla və sitat gətirilə bildiyini yoxlayır.
Hər tapıntı altı sütun və 600+ KPI üzrə öz sübutu və təsirə görə sıralanmış düzəlişi ilə gəlir. Pulsuz plan hər skanda 10 səhifəyə qədər, 24 saatda 3 skan oxuyur. Necə qiymətləndiririk səhifəsinə baxın və ya audit keçirin.
Əsas nəticələr
- Sayt AI crawlerlərini robots.txt-də, CDN-in bot ayarlarında və firewall-da bloklaya bilər; robots.txt tövsiyə xarakterlidir, digər ikisi məcburi tətbiq olunur və hər üçü yoxlanmalıdır.345
- Təlim, axtarış və istifadəçi crawlerləri OpenAI, Anthropic və Perplexity-də ayrı açarları olan ayrı istifadəçi agentləridir; Google-Extended istifadəçi agenti olmayan robots.txt tokenidir və Google Axtarışa heç vaxt təsir etmir.3647
- HasData müəyyən etdi ki, GPTBot-u qadağan edən saytların 39.5%-i ona yenə də səhifə verir, naşirlər isə GPTBot istifadəçi agentinə brauzerdən 30 bal az cavab verir: fayl və server hər iki istiqamətdə uyğun gəlmir.5
- Cloudflare indi AI trafikini Search, Training və Agent-ə bölür, köhnə "Block AI Bots" domenlərini Search Allow-a keçirib və xəbərdarlıq edir ki, Search-də Block Googlebot və Bingbot-u da bloklayır.1
- Firewall
403-ü Google-a səhifənin mövcud olmadığını deyir və onu indeksdən çıxarır;429yalnız crawl-ı yavaşladır.10 Real crawler istifadəçi agenti ilə test edin və200gözləyin.3
Problemin məzmununuzda, yoxsa qapılarınızda olduğunu öyrənmək üçün on dəqiqə kifayətdir. Faylı açın, paneli açın, iki sorğu göndərin. Hər üç qat axtarış crawlerlərini buraxırsa, qalan məzmun məsələsidir.
Əlaqəli məqalələr: AI crawlerləri saytınızı oxuya bilirmi? 10 dəqiqəlik texniki yoxlama və Sayt təhlükəsizliyi reytinqə və müştəri etibarına necə təsir edir
Altı sütun üzrə bələdçilər: Texniki · Məzmun keyfiyyəti · Etibar · Aktuallıq · Təhlükəsizlik · SEO və GEO · ContentMas hər sütunu necə qiymətləndirir
Tez-tez verilən suallar
GPTBot-u bloklamaq saytımı ChatGPT axtarışından kənarda saxlayır?
Xeyr. OpenAI təlim üçün GPTBot-dan, axtarış üçün OAI-SearchBot-dan istifadə edir və deyir ki, "Hər ayar digərlərindən müstəqildir."3 Yalnız OAI-SearchBot-dan imtina edən saytlar "ChatGPT axtarış cavablarında göstərilməyəcək," baxmayaraq ki, onlar "yenə də naviqasiya linkləri kimi görünə bilər."3
Google-Extended-i bloklamaq səhifələrimi AI Overviews-dan çıxarır?
Xeyr. Google deyir ki, Google-Extended "saytın Google Axtarışa daxil edilməsinə təsir etmir və sıralama siqnalı kimi istifadə olunmur," o yalnız crawl edilmiş məzmunun Gemini modellərinin təlimi və əsaslandırılması üçün istifadə olunub-olunmadığını idarə edir.7 AI Overviews və AI Mode üçün idarəetmə vasitəsi Googlebot üçün robots.txt qaydasıdır və Google crawl-a "istənilən CDN və ya hostinq infrastrukturu tərəfindən" də icazə verilməsini istəyir.2
2025-ci ildə Cloudflare-in "Block AI Bots" açarını aktiv etmişəm. O hələ də axtarış crawlerlərini bloklayır?
Çox güman ki, yox. Cloudflare qranular idarəetmələri heç vaxt istifadə etməmiş domenləri Search Allow, Training "Disallow AI Training" və Agent "Block on pages with ads" ayarlarına keçirdi.1 Search siyasətini açın və Allow olduğunu təsdiqləyin, çünki oradakı Block indi Googlebot, Bingbot və Applebot-a da tətbiq olunur.1
Robots.txt-ni dəyişdikdən sonra crawler bunu nə vaxt görür?
Təxminən bir gündən sonra. Google robots.txt-ni "24 saata qədər" keşdə saxlayır,8 OpenAI deyir ki, axtarış sistemlərinin uyğunlaşması "~24 saat" çəkir,3 Perplexity isə dəyişikliklərin "24 saata qədər" çəkə biləcəyini bildirir.4 Firewall dəyişikliyi növbəti sorğudan qüvvəyə minir.
Firewall robots.txt-yə məhəl qoymayan AI crawlerlərini bloklaya bilər?
Bəli, və bu, ChatGPT-User və Perplexity-User kimi istifadəçi tərəfindən işə salınan fetcherlər üçün düzgün vasitədir; onların öz sənədləri robots.txt qaydalarının onlara tətbiq olunmaya biləcəyini deyir.34 Onları istifadəçi agentinə və vendorların dərc etdiyi IP aralıqlarına görə tutuşdurun34 və 403-ü yalnız rədd etmək istədiyiniz crawlerlərə qaytarın, axtarış crawlerlərinə heç vaxt.10
İstinadlar
Məqalədəki hər nömrəli işarə aşağıdakı mənbəyə keçid verir.
-
Cloudflare — Have it both ways: stay discoverable in search while disallowing AI training (yeni vərəqdə açılır), sentyabr 2026. ↩
-
Google Search Central — AI features and your website (yeni vərəqdə açılır), dekabr 2025. ↩
-
OpenAI — Overview of OpenAI Crawlers (yeni vərəqdə açılır), noyabr 2026-da baxılıb. ↩
-
Perplexity — Perplexity Crawlers (yeni vərəqdə açılır), noyabr 2026-da baxılıb. ↩
-
HasData — The AI Crawler Block Index (yeni vərəqdə açılır), oktyabr 2026. ↩
-
Anthropic — Does Anthropic crawl data from the web, and how can site owners block the crawler? (yeni vərəqdə açılır), oktyabr 2026. ↩
-
Google Search Central — Google's common crawlers (yeni vərəqdə açılır), oktyabr 2026. ↩
-
Google Search Central — How Google interprets the robots.txt specification (yeni vərəqdə açılır), oktyabr 2026. ↩
-
Vercel — WAF Managed Rulesets (yeni vərəqdə açılır), sentyabr 2026. ↩
-
Google Search Central — How HTTP status codes affect Google's crawlers (yeni vərəqdə açılır), fevral 2026. ↩
Bu məqalə haqqında
Müəllif: Nasir Ali Joiya, ZAPTA Technologies-in baş direktoru və həmtəsisçisi. Məqaləni saytları Google və AI axtarış sistemləri üçün altı sütun üzrə yoxlayan, süni intellektlə işləyən SEO audit aləti ContentMas-ı quran ContentMas komandası yoxlayıb. Faktlar və rəqəmlər Mənbələr bölməsindəki orijinal mənbələrə keçid verir. Köhnəlmiş bir şey gördünüz? Bizə yazın, düzəldək.
Pulsuz veb sayt auditi
Saytınızın axtarış sistemləri və AI köməkçiləri üçün balını görün.
Bir neçə dəqiqəyə bir bal, altı sütun balı və sıralanmış düzəliş siyahısı. Kredit kartı tələb olunmur.
Pulsuz auditə başla