
الجاهزية التقنية
هل تستطيع زواحف الذكاء الاصطناعي قراءة موقعك؟ فحص تقني في 10 دقائق
كثير من زواحف الذكاء الاصطناعي لا تقرأ إلا HTML الخام وتلتزم بملف robots.txt. افحص الوصول وnoindex والعرض ورموز الحالة وcanonical وsitemap والسرعة وschema في 10 دقائق.
 بقلم Nasir Ali Joiya, الرئيس التنفيذي والمؤسس المشارك لشركة ZAPTA Technologiesنُشر في 11 دقائق قراءة 11 مصادر موثقة
لخّص بالذكاء الاصطناعي
وقتك ضيق؟ افتح هذا المقال في مساعد الذكاء الاصطناعي الذي تستخدمه مع طلب جاهز.
- ChatGPT (يُفتح في علامة تبويب جديدة مع طلب تلخيص)
- Perplexity (يُفتح في علامة تبويب جديدة مع طلب تلخيص)
- Grok (يُفتح في علامة تبويب جديدة مع طلب تلخيص)
يُفتح Claude وGemini والطلب منسوخ مسبقًا: الصقه للبدء.
في هذه الصفحة
- لماذا يبدو الموقع سليمًا في المتصفح لكنه لا يظهر في البحث أو في إجابات الذكاء الاصطناعي؟
- هل تعرض زواحف الذكاء الاصطناعي JavaScript؟
- كيف تتحقق في 10 دقائق من قدرة زواحف الذكاء الاصطناعي على قراءة موقعك؟
- كيف تبدو النتيجة الجيدة في كل فحص؟
- هل يحظر Cloudflare زواحف الذكاء الاصطناعي على موقعي؟
- لماذا تهم وسوم canonical وخرائط الموقع في بحث الذكاء الاصطناعي؟
- ماذا يكشف التدقيق التقني عادةً؟
- كيف تفحص ContentMas ذلك
- الأسئلة الشائعة
الإجابة المختصرة
باختصار: ربما لا، حتى لو بدا الموقع مثاليًا في متصفحك. فزواحف الذكاء الاصطناعي الكبرى لا تشغّل JavaScript، لذا يبقى المحتوى الذي لا يظهر إلا بعد تحميل السكربتات غير مرئي لها،1 كما أن قاعدة في robots.txt أو وسم noindex أو إعدادًا للبوتات في شبكة CDN قد يمنعها من الدخول تمامًا. تستغرق الفحوص الثمانية أدناه نحو عشر دقائق، وتكشف لك هل تستطيع محركات البحث ومساعدات الذكاء الاصطناعي قراءة صفحاتك فعلًا.
الشكوى المعتادة: "الموقع يبدو سليمًا، لكنه لا يظهر في Google ولا في إجابات الذكاء الاصطناعي". المتصفح قارئ متسامح: يشغّل كل سكربت، ويتبع كل تحويل، ويتجاهل robots.txt. أما الزواحف فأكثر صرامة.
يتناول هذا الدليل البنية التقنية لا الكتابة. أما جانب المحتوى فاقرأ عنه دليلنا (باللغة الإنجليزية) How to Optimize Your Content for ChatGPT, Perplexity, and AI Overviews.
لماذا يبدو الموقع سليمًا في المتصفح لكنه لا يظهر في البحث أو في إجابات الذكاء الاصطناعي؟
لأن الزاحف يرى نسخة من موقعك تختلف عمّا تراه أنت. فقد يُحظر قبل أن يصل إلى الصفحة، وقد يتلقى رمز خطأ أو سلسلة تحويلات طويلة، وقد يستلم هيكل HTML فارغًا لا يتحول إلى صفحة إلا بعد تشغيل JavaScript.
لا شيء من ذلك يظهر على الشاشة. فقد تُحمَّل الصفحة بسرعة للزوار بينما تطلب قاعدة noindex من Google إبقاءها خارج نتائج البحث.2 ويُظهر تقرير Web Almanac لعام 2024 مدى شيوع هذه الإشارات: ظهرت قاعدة noindex في HTML المعروض لـ 3.9% من صفحات الجوال، وأخفقت 7.40% من صفحات الجوال في فحص Lighthouse للتحقق من صحة ملف robots.txt.3 بعضها مقصود، وبعضها بقايا من بيئة الاختبار.
هل تعرض زواحف الذكاء الاصطناعي JavaScript؟
معظمها لا يفعل. اختبرت Vercel زواحف الذكاء الاصطناعي الكبرى عبر شبكتها، ووجدت أن أيًّا منها لم يعرض JavaScript؛ فزاحفا ChatGPT وClaude جلبا ملفات JavaScript لكنهما لم يشغّلاها.1 ويُستثنى من ذلك Gemini من Google، لأنه يستخدم البنية التحتية لـ Googlebot التي تعرض الصفحات.1
أما Google نفسه فيعرض JavaScript في خطوة منفصلة بعد الزحف، لكنه يؤكد أن العرض من جهة الخادم أو العرض المسبق "لا يزال فكرة ممتازة"، لأن البوتات ليست كلها قادرة على تشغيل JavaScript.4 القاعدة العملية: يجب أن يكون نصك الأساسي وعناوينك وروابطك وبياناتك المنظمة موجودة في HTML الذي يرسله الخادم، لا أن يضيفها سكربت لاحقًا.
ووجدت الدراسة نفسها أن زاحف ChatGPT أنفق 34.82% من عمليات الجلب على صفحات 404، و14.36% أخرى على تتبع التحويلات، مقارنةً بـ 8.22% و1.49% لدى Googlebot.1 فالروابط المعطلة والمنقولة تهدر جزءًا كبيرًا من جهد زواحف الذكاء الاصطناعي.
كيف تتحقق في 10 دقائق من قدرة زواحف الذكاء الاصطناعي على قراءة موقعك؟
اختر صفحتك الرئيسية وصفحة داخلية مهمة، مثل صفحة الأسعار. تستغرق كل خطوة نحو دقيقة.
- اقرأ ملف robots.txt. افتح
yourdomain.com/robots.txt. ابحث عنDisallow: /تحتUser-agent: *أو تحت أسماء بوتات ذكاء اصطناعي بعينها. يشرح دليلنا عن الظهور في الذكاء الاصطناعي أي زواحف OpenAI وPerplexity وGoogle تتحكم في الإدراج في البحث، وأيها يتحكم في التدريب فقط. - راجع إعدادات البوتات في شبكة CDN. إن كنت تستخدم Cloudflare أو خدمة مماثلة، فافتح إعدادات البوتات أو زواحف الذكاء الاصطناعي فيها، وتأكد من أنها تطابق ما تريده (انظر القسم التالي).
- ابحث عن
noindex. اعرض مصدر الصفحة وابحث عنnoindex. ثم افحص ترويسات الاستجابة (أدوات المطوّر في المتصفح، تبويب Network) بحثًا عن ترويسةX-Robots-Tag. يدعم Google هذه الترويسة للملفات غير HTML مثل الصور.2 - قارن مصدر الصفحة بالصفحة المعروضة. اضغط Ctrl+U (أو Cmd+Option+U على Mac) وابحث عن جملة من منتصف صفحتك. إن لم تجدها في المصدر، فهي تُحمَّل عبر JavaScript، ولن يراها كثير من زواحف الذكاء الاصطناعي.1
- افحص رمز الحالة والتحويلات. شغّل
curl -I https://yourdomain.com/pageأو استخدم أداة لفحص التحويلات. المطلوب هو200على الرابط النهائي بقفزة واحدة على الأكثر. لا يفهرس Google الروابط التي تُرجع رمزًا من فئة 4xx، وزواحفه تتبع ما يصل إلى 10 قفزات تحويل افتراضيًا.5 ننصح بقفزة واحدة، لأن زواحف أخرى قد تتوقف قبل ذلك. - افحص وسم canonical. ابحث في المصدر عن
rel="canonical". يجب أن يشير إلى الرابط النظيف للصفحة نفسها، مكتوبًا كرابط مطلق كما ينصح Google.6 - افتح خريطة الموقع. جرّب
yourdomain.com/sitemap.xmlوابحث عن سطرSitemap:في robots.txt. تأكد من أن الصفحة المهمة مدرجة برابطها الكامل.7 - اختبر السرعة والبيانات المنظمة. مرّر الصفحة عبر PageSpeed Insights، ثم عبر اختبار النتائج المنسّقة (Rich Results Test) من Google لاكتشاف أخطاء schema.8
إن أخفقت خطوة، فأصلحها قبل أي عمل على المحتوى. فالمحتوى لا ينفع صفحة لا تستطيع الزواحف قراءتها.
كيف تبدو النتيجة الجيدة في كل فحص؟
| الفحص | كيف تختبره في دقيقة | كيف تبدو النتيجة الجيدة | الأداة |
|---|---|---|---|
| robots.txt | افتح /robots.txt واقرأ القواعد | الصفحات التي تريد ظهورها غير محظورة على زواحف البحث | المتصفح |
| إعدادات البوتات في CDN | راجع إعدادات زواحف الذكاء الاصطناعي في لوحة تحكم CDN | الإعدادات تطابق اختيارك؛ ويُسأل أصحاب النطاقات الجديدة في Cloudflare عند التسجيل9 | لوحة تحكم Cloudflare |
| noindex / X-Robots-Tag | ابحث في المصدر عن noindex؛ واقرأ ترويسات الاستجابة | لا noindex على الصفحات التي تريدها في البحث؛ والصفحة قابلة للزحف حتى تُقرأ القاعدة2 | عرض المصدر، أدوات المطوّر |
| HTML معروض من الخادم | ابحث عن جملة أساسية في مصدر الصفحة | النص الأساسي والروابط وschema موجودة في HTML الخام14 | عرض المصدر |
| رموز الحالة والتحويلات | شغّل curl -I على الرابط | 200 على الرابط النهائي، وقفزة تحويل واحدة على الأكثر؛ ولا 4xx أبدًا للصفحات الحية5 | curl، أداة فحص التحويلات |
| وسم canonical | ابحث في المصدر عن rel="canonical" | رابط مطلق واحد يشير إلى النسخة المفضلة6 | عرض المصدر |
| خريطة موقع XML | افتح /sitemap.xml | روابط مطلقة، وأقل من 50,000 رابط أو 50 MB لكل ملف، ومدرجة في robots.txt7 | المتصفح، Search Console |
| Core Web Vitals | شغّل PageSpeed Insights | LCP ≤ 2.5 ثانية، INP ≤ 200 ملي ثانية، CLS ≤ 0.1 عند المئين الـ 7510 | PageSpeed Insights |
| البيانات المنظمة | الصق الرابط في Rich Results Test | لا أخطاء؛ وJSON-LD يطابق المحتوى الظاهر8 | Rich Results Test |
المصدر: جمعته ContentMas من Vercel وCloudflare وGoogle Search Central وweb.dev.1924567108
ملاحظة حول Core Web Vitals: تُقاس العتبات عند المئين الـ 75 من مشاهدات الصفحة الفعلية، أي أن ثلاث زيارات على الأقل من كل أربع يجب أن تستوفي كل عتبة.10 السرعة ليست بوابة مثل robots.txt، لكن الصفحات البطيئة تضر بالزوار الذين ترسلهم إليك الزواحف.
هل يحظر Cloudflare زواحف الذكاء الاصطناعي على موقعي؟
قد يكون ذلك، وربما دون أن تختاره. فمنذ يوليو 2025، يحظر Cloudflare افتراضيًا زواحف الذكاء الاصطناعي التي تصل إلى المحتوى دون إذن، ويسأل كل نطاق جديد عند التسجيل هل يسمح لها أم لا.9
وتقول Cloudflare إن العملاء يمكنهم مراجعة إعداداتهم وتفعيل الزحف في أي وقت.9 إن كان موقعك خلف Cloudflare، أو خلف أي شبكة CDN أو جدار حماية فيه قواعد للبوتات، فاجعل هذا قرارًا مدروسًا. والنمط الشائع أن الإعداد اختاره أثناء التهيئة من ضبط DNS، ولم يسمع به فريق التسويق قط.
حظر تدريب الذكاء الاصطناعي خيار مشروع. فقط تأكد من أنك لا تحظر معه زواحف البحث التي تقرر هل تظهر في إجابات الذكاء الاصطناعي أم لا.
لماذا تهم وسوم canonical وخرائط الموقع في بحث الذكاء الاصطناعي؟
لأنها تخبر الزواحف أي رابط هو الأصلي وأين توجد صفحاتك المهمة. يصف Google وسم rel="canonical" بأنه "إشارة قوية" على الرابط الذي ينبغي أن يصبح الأساسي، ويحذّر من استخدام robots.txt لتحديد الرابط الأساسي.6 وفي تقرير Web Almanac لعام 2024، احتوت 65% من صفحات الجوال على وسم canonical.3
عند وجود نسخ مكررة، مثل معاملات التتبع أو النسخ الإقليمية، قد يقرأ الزاحف النسخة الخطأ. يشرح دليلنا (باللغة الإنجليزية) Which Pages Should a Website Audit Check First? كيف تتسلل النسخ المكررة.
تساعد خرائط الموقع الزواحف على اكتشاف الصفحات التي تفوتها الروابط الداخلية. حدود Google هي 50 MB غير مضغوط أو 50,000 رابط لكل ملف خريطة موقع، مع روابط مطلقة، ويمكنك الإشارة إلى خريطة الموقع من robots.txt بسطر Sitemap:.7
ماذا يكشف التدقيق التقني عادةً؟
يكشف التدقيق التقني عادةً عن بضع عوائق صغيرة قابلة للإصلاح بدلًا من عطل كبير واحد: وسم noindex منسي، أو canonical يشير إلى الرابط الخطأ، أو سلسلة تحويلات متبقية من عملية نقل، أو قسم أساسي لا يُحمَّل إلا عبر JavaScript.
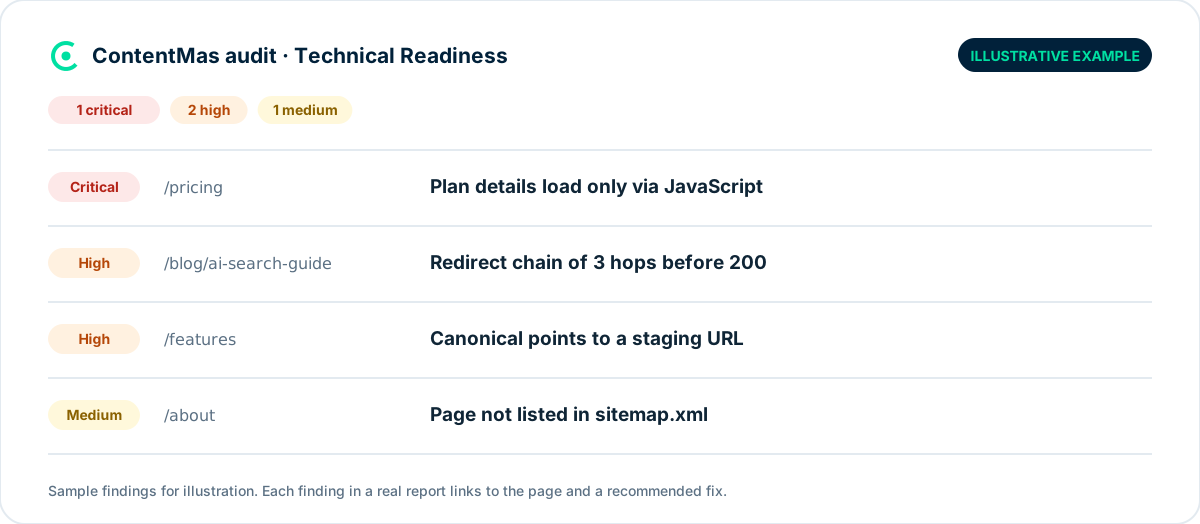
المصدر: مثال توضيحي لتقرير من ContentMas لموقع افتراضي، وليس بيانات حقيقية. الفحوص المعروضة تتبع إرشادات Google Search Central.4567
ننصح بالإصلاح بهذا الترتيب: كل ما يمنع الوصول أولًا (robots.txt، وقواعد CDN، وnoindex، وأخطاء 4xx و5xx)، ثم العرض، ثم canonical والتحويلات، ثم خريطة الموقع والسرعة وschema. ويشير Google إلى أن أخطاء 5xx تجعل زواحفه تبطئ مؤقتًا،5 أي أن أخطاء الخادم تكلّف وقت زحف فوق خسارة الصفحة نفسها.
كيف تفحص ContentMas ذلك
تدقق ContentMas صفحاتك الأساسية وفق أكثر من 600 مؤشر أداء (KPI) موزعة على ست ركائز. وتنظر ركيزة الجاهزية التقنية في قدرة الزواحف على الوصول إلى كل صفحة وقراءتها: إشارات الزحف والفهرسة، ورموز الحالة والتحويلات، وإعداد canonical وخريطة الموقع، ومقدار المحتوى الموجود في HTML المرسل من الخادم، وأداء الصفحة، وصحة البيانات المنظمة.
تحصل كل نتيجة على أولوية حرجة أو عالية أو متوسطة أو منخفضة، مع توصية بالإصلاح، فتعرف أي عائق تزيله أولًا. تقيس ContentMas جاهزية موقعك، ولا تتتبع عدد مرات ذكر أدوات الذكاء الاصطناعي لك. ابدأ التدقيق المجاني على ما يصل إلى 50 صفحة، أو اقرأ كيف نحسب الدرجات لترى كيف تتحول النتائج إلى درجات.
اقرأ أيضًا: How to Optimize Your Content for ChatGPT, Perplexity, and AI Overviews · SEO مقابل GEO · أمان الموقع وSEO والثقة
أدلة الركائز الست: جودة المحتوى · الثقة · الحداثة · الأمان · SEO وGEO · كيف تقيّم ContentMas كل ركيزة
الأسئلة الشائعة
كيف أعرف هل تستطيع زواحف الذكاء الاصطناعي الوصول إلى موقعي؟
افحص robots.txt بحثًا عن قواعد تحظر بوتات الذكاء الاصطناعي، وراجع إعدادات البوتات في شبكة CDN، وتأكد من أن محتواك الأساسي موجود في مصدر الصفحة لا يُحمَّل عبر JavaScript. فزواحف الذكاء الاصطناعي الكبرى لا تعرض JavaScript، لذا فالمحتوى الغائب عن مصدر الصفحة غائب عنها على الأرجح أيضًا.1
هل يؤدي حظر GPTBot إلى إزالة موقعي من بحث ChatGPT؟
ليس وحده. تقول OpenAI إن OAI-SearchBot يُستخدم لإظهار المواقع في ميزات البحث في ChatGPT، بينما يخدم GPTBot تدريب النماذج، وإن كل إعداد مستقل عن الآخر.11 ويقارن دليلنا عن الظهور في الذكاء الاصطناعي بين الزواحف الرئيسية جنبًا إلى جنب.
هل يحتاج Google إلى العرض من جهة الخادم لفهرسة موقعي؟
لا. يعرض Google JavaScript كجزء من الزحف والفهرسة.4 لكنه لا يزال يصف العرض من جهة الخادم أو العرض المسبق بأنه "فكرة ممتازة"، لأن البوتات ليست كلها قادرة على تشغيل JavaScript،4 ومنها معظم زواحف الذكاء الاصطناعي.1
هل يعمل وسم noindex إذا كان robots.txt يحظر الصفحة؟
لا. يقول Google إن إعدادات robots meta وX-Robots-Tag لا يمكن قراءتها واتباعها إلا إذا سُمح للزواحف بالوصول إلى الصفحة.2 إن أردت إخراج صفحة من البحث، فاسمح بالزحف واستخدم noindex.
هل تؤثر Core Web Vitals على الظهور في بحث الذكاء الاصطناعي؟
لا توجد منصة ذكاء اصطناعي من التي نستشهد بها تعلن السرعة شرطًا لاعتماد موقع كمصدر. ومع ذلك ننصح باستيفاء العتبات "الجيدة": LCP عند 2.5 ثانية، وINP عند 200 ملي ثانية، وCLS عند 0.1،10 لأن من ينقرون من نتائج البحث وإجابات الذكاء الاصطناعي يصلون إلى تلك الصفحة.
المراجع
كل رقم في المقال يحيل إلى مصدره أدناه.
-
Vercel — The rise of the AI crawler (يُفتح في علامة تبويب جديدة)، ديسمبر 2024. ↩
-
Google Search Central — Robots meta tag, data-nosnippet, and X-Robots-Tag specifications (يُفتح في علامة تبويب جديدة)، مارس 2026. ↩
-
HTTP Archive — Web Almanac 2024: SEO (يُفتح في علامة تبويب جديدة)، إصدار 2024. ↩
-
Google Search Central — Understand the JavaScript SEO basics (يُفتح في علامة تبويب جديدة). ↩
-
Google Search Central — How HTTP status codes, and network and DNS errors affect Google Search (يُفتح في علامة تبويب جديدة)، فبراير 2026. ↩
-
Google Search Central — How to specify a canonical with rel="canonical" and other methods (يُفتح في علامة تبويب جديدة)، يوليو 2026. ↩
-
Google Search Central — Build and submit a sitemap (يُفتح في علامة تبويب جديدة)، يوليو 2026. ↩
-
Google Search Central — General structured data guidelines (يُفتح في علامة تبويب جديدة)، يوليو 2026. ↩
-
Cloudflare via Business Wire — Cloudflare Just Changed How AI Crawlers Scrape the Internet-at-Large; Permission-Based Approach Makes Way for A New Business Model (يُفتح في علامة تبويب جديدة)، يوليو 2025. ↩
-
web.dev — How the Core Web Vitals metrics thresholds were defined (يُفتح في علامة تبويب جديدة)، مايو 2025. ↩
-
OpenAI — Overview of OpenAI Crawlers (يُفتح في علامة تبويب جديدة). ↩
عن هذا المقال
كتبه Nasir Ali Joiya، الرئيس التنفيذي والمؤسس المشارك لشركة ZAPTA Technologies. راجعه فريق ContentMas الذي يطوّر ContentMas، وهي أداة لتدقيق المواقع تفحص المواقع وفق ست ركائز لمحركات البحث ومساعدي الذكاء الاصطناعي. ترتبط الحقائق والأرقام بمصادرها الأصلية في قسم المراجع. هل لاحظت معلومة قديمة؟ راسلنا وسنصححها.
تدقيق مجاني للموقع
اعرف درجة موقعك لدى محركات البحث ومساعدي الذكاء الاصطناعي.
درجة واحدة، ودرجات الركائز الست، وقائمة إصلاحات مرتبة خلال دقائق. دون بطاقة ائتمان.
ابدأ التدقيق المجاني