
الجاهزية التقنية
هل يحظر موقعك زواحف الذكاء الاصطناعي؟ فحص في 10 دقائق
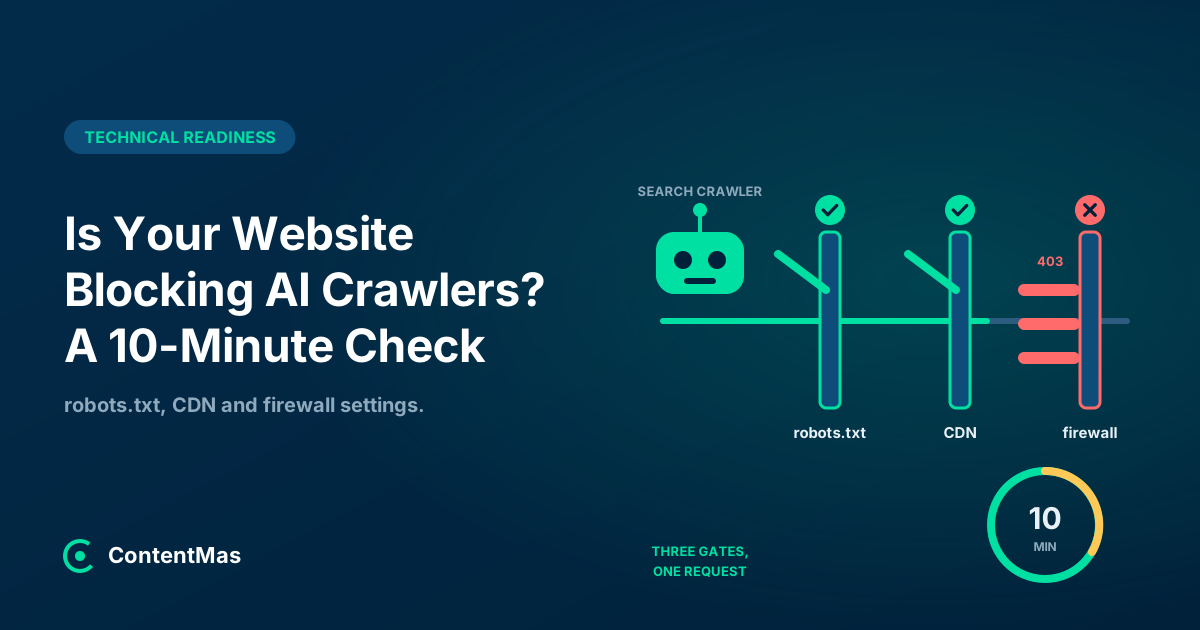
قد يحظر الموقع زواحف الذكاء الاصطناعي في robots.txt أو في إعدادات الروبوتات في شبكة CDN أو في جدار الحماية، غالبًا دون أن يقرر أحد ذلك. ثلاثة فحوص تستغرق 10 دقائق.
 بقلم Nasir Ali Joiya, الرئيس التنفيذي والمؤسس المشارك لشركة ZAPTA Technologiesنُشر في 15 دقائق قراءة 10 مصادر موثقة
لخّص بالذكاء الاصطناعي
وقتك ضيق؟ افتح هذا المقال في مساعد الذكاء الاصطناعي الذي تستخدمه مع طلب جاهز.
- ChatGPT (يُفتح في علامة تبويب جديدة مع طلب تلخيص)
- Perplexity (يُفتح في علامة تبويب جديدة مع طلب تلخيص)
- Grok (يُفتح في علامة تبويب جديدة مع طلب تلخيص)
يُفتح Claude وGemini والطلب منسوخ مسبقًا: الصقه للبدء.
في هذه الصفحة
- أين يمكن أن يحظر الموقع زواحف الذكاء الاصطناعي؟
- أي زواحف الذكاء الاصطناعي تقرر ما إذا كان سيُستشهد بك؟
- الخطوة 1: ماذا يقول ملف robots.txt لديك فعلًا؟ (3 دقائق)
- الخطوة 2: ماذا قررت شبكة CDN نيابةً عنك؟ (3 دقائق)
- الخطوة 3: هل يسمح جدار الحماية بمرور الزاحف؟ (3 دقائق)
- ما الذي ينبغي أن تسمح به وما الذي ينبغي أن تحظره؟
- كيف تساعد ContentMas في مسألة حظر زواحف الذكاء الاصطناعي؟
- أهم النقاط
- الأسئلة الشائعة
الإجابة المختصرة
باختصار: قد يحدث حظر زواحف الذكاء الاصطناعي في ثلاثة أماكن: ملف robots.txt، وإعدادات الروبوتات في شبكة CDN، وجدار حماية الخادم أو إضافة الأمان، ومعظم أصحاب المواقع لا يفحصون سوى الأول. وكثيرًا ما تكون هذه الإعدادات من اختيار مزوّد الاستضافة أو إعدادًا افتراضيًا، لا من اختيارك أنت: فتمنح Cloudflare الآن كل نطاق جديد واحدًا من إعدادين مسبقين بحسب ما إذا كان يعرض إعلانات، ونقلت في سبتمبر 2026 كل نطاق قديم مفعّل فيه خيار "Block AI Bots" إلى القواعد الجديدة،1 ونصيحة Google نفسها للظهور في ميزات الذكاء الاصطناعي هي التأكد من أن "الزحف مسموح به في robots.txt، ومن قِبل أي CDN أو بنية استضافة".2 وتشغّل كل شركة ذكاء اصطناعي زواحف منفصلة للتدريب والبحث وطلبات المستخدمين، لكل منها مفتاحه الخاص،3 لذا يتأكد الفحص من أن الزواحف التي تقرر ما إذا كان سيُستشهد بك لم تقع في قاعدة كُتبت لغرض آخر. والخطوات الثلاث أدناه تستغرق نحو عشر دقائق.
تقرأ أن مساعدات الذكاء الاصطناعي ترسل زوارًا، فتتحقق، فلا يظهر موقعك أبدًا. ويبدو ملف robots.txt سليمًا، فيكون الاستنتاج: "محتوانا ليس جيدًا بما يكفي".
وكثيرًا ما يكون الزاحف لم يدخل أصلًا. فمفتاح في شبكة CDN اختير عند التسجيل، أو إضافة أمان تحظر "الروبوتات السيئة" بحسب وكيل المستخدم، أو حد للمعدل يرد بـ 403 على كل ما يجلب الصفحات بسرعة، كلها قد تغلق الباب أمام زواحف البحث لدى ChatGPT وClaude وPerplexity وGoogle دون سطر واحد في robots.txt.
يغطي هذا الدليل الوصول فقط. أما ما إذا كان الزاحف يستطيع قراءة ما يجده (JavaScript وnoindex وعمليات إعادة التوجيه) فهو موضوع الفحص التقني في 10 دقائق.
أين يمكن أن يحظر الموقع زواحف الذكاء الاصطناعي؟
في ثلاث طبقات، وعلى الزاحف أن يعبرها جميعًا. الأولى إرشادية، والأخريان مفروضتان.
| الطبقة | ما تفعله | من يضبطها عادةً | كيف يراها الزاحف المحظور |
|---|---|---|---|
| robots.txt | تطلب من الزواحف الابتعاد عن مسارات معينة أو عن الموقع كله | المطوّر، أو إضافة SEO، أو شبكة CDN نيابةً عنك | يقرأ القاعدة ويغادر (إن كان يلتزم بها) |
| إعدادات الروبوتات في CDN (Cloudflare وVercel وغيرهما) | تحظر الطلبات أو تتحداها بحسب فئة الروبوت قبل أن تصل إلى خادمك | من أعدّ DNS، أو إعداد افتراضي عند التسجيل | 403، أو صفحة تحدٍّ، أو اتصال مقطوع |
| جدار الحماية، وWAF، وإضافة الأمان، وحدود المعدل | تحظر بحسب وكيل المستخدم أو نطاق IP أو سرعة الطلبات على الخادم | مزوّد الاستضافة أو إضافة أمان | 403 أو 401 أو 429 أو انتهاء المهلة |
الطبقة الأولى طوعية بحكم تصميمها. فالزواحف التي تجلب صفحة لأن شخصًا طلبها تقول ذلك في وثائقها: تشير OpenAI بخصوص ChatGPT-User إلى أنه "نظرًا لأن هذه الإجراءات يبدؤها مستخدم، فقد لا تنطبق قواعد robots.txt"،3 وتقول Perplexity عن Perplexity-User إنه "بما أن مستخدمًا طلب الجلب، فإن هذا الجالب يتجاهل قواعد robots.txt عمومًا".4 أما الطبقتان الثانية والثالثة فهما حيث تُحظر المواقع دون قصد، لأن القواعد هناك مكتوبة لـ "الروبوتات" عمومًا.
ما يقوله robots.txt وما يفعله الخادم شيئان مختلفان، في الاتجاهين. وعلى الفحص أن يغطيهما معًا.
أي زواحف الذكاء الاصطناعي تقرر ما إذا كان سيُستشهد بك؟
زواحف البحث والمستخدمين، لا زواحف التدريب. فكل شركة ذكاء اصطناعي كبرى تقسّم حركتها إلى وكلاء مستخدم منفصلين، ولكل منهم إعداده الخاص.
| الشركة | زاحف التدريب | زاحف البحث أو الفهرسة | الجالب الذي يشغّله المستخدم | ما تقوله الوثائق |
|---|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User | "كل إعداد مستقل عن الإعدادات الأخرى"؛ والمواقع التي تنسحب من OAI-SearchBot "لن تظهر في إجابات بحث ChatGPT"3 |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User | تعطيل Claude-SearchBot "قد يقلل من ظهور موقعك ودقته في نتائج بحث المستخدمين"6 |
| Perplexity | لا يوجد زاحف مدرج؛ فـ PerplexityBot "لا يُستخدم لزحف المحتوى من أجل نماذج الذكاء الاصطناعي الأساسية" | PerplexityBot | Perplexity-User | توصي بالسماح لـ PerplexityBot ونطاقات IP المنشورة له4 |
| Google-Extended (رمز في robots.txt فقط) | Googlebot | غير مشمول هنا | قواعد robots.txt الخاصة بـ Googlebot هي "أداة التحكم" في AI Overviews وAI Mode2؛ وGoogle-Extended "لا يؤثر في إدراج الموقع في بحث Google"7 |
تفصيلان مهمان للفحص. أولًا، الموقع الذي ينسحب من OAI-SearchBot يمكن أن "يظهر مع ذلك كروابط تنقّل"، لكن ليس في إجابات البحث،3 لذا فإن حظر الروبوت الخطأ لا يبدو حظرًا في سجلاتك: الحركة ببساطة لا تأتي أبدًا. ثانيًا، Google-Extended "ليس له سلسلة وكيل مستخدم منفصلة في طلبات HTTP"؛ بل "يُستخدم رمز وكيل المستخدم في robots.txt بصفة تحكمية".7 فلا يمكن لقاعدة في جدار الحماية أن تطابقه أبدًا، وقاعدة له في robots.txt لا تغيّر شيئًا في البحث: فهي تتحكم فقط فيما إذا كانت Google تستخدم صفحاتك لتدريب نماذج Gemini وتأسيس إجاباتها.7
حظر زواحف التدريب خيار مشروع. أما الخطأ فهو قاعدة كُتبت لـ GPTBot أو "روبوتات الذكاء الاصطناعي" وتلتقط معها بهدوء OAI-SearchBot وClaude-SearchBot وPerplexityBot.
الخطوة 1: ماذا يقول ملف robots.txt لديك فعلًا؟ (3 دقائق)
افتح yourdomain.com/robots.txt في المتصفح، ثم اجلبه من سطر الأوامر لترى رمز الحالة الذي يحصل عليه الزاحف:
curl -s -o /dev/null -w "%{http_code}\n" https://yourdomain.com/robots.txt
curl -s https://yourdomain.com/robots.txt
ابحث عن أربعة أشياء.
1. القواعد الشاملة
User-agent: * متبوعًا بـ Disallow: / يحظر كل زاحف يلتزم به، بما في ذلك محركات البحث. أما Disallow: / تحت اسم روبوت ذكاء اصطناعي بعينه فيحظر ذلك الروبوت وحده. اقرأ كل كتلة User-agent: فقاعدة لـ GPTBot لا بأس بها إن كنت تقصدها، أما قاعدة لـ OAI-SearchBot أو PerplexityBot فتعني أنك انسحبت من الاستشهاد بك.
2. أسطر لم تكتبها أنت
قد تضيف شبكة CDN إلى هذا الملف، وقد تحذف منه. فقد وجدت HasData توجيهًا للانسحاب من الذكاء الاصطناعي في نسخ robots.txt المؤرشفة لـ 118 موقعًا خلف Cloudflare في يوليو 2026، ولم تجده في أي من تلك المواقع في 16 سبتمبر 2026؛ وبين المواقع خلف Cloudflare انخفضت نسبة المواقع التي تمنع GPTBot من 17.1% إلى 9.9% بين اللقطتين، بينما تحركت المواقع غير الموجودة خلف Cloudflare من 18.7% إلى 18.6%.5 فإذا ظهر أو اختفى سطر لم تحرره قط، فالإعداد الذي يولّده موجود في لوحة تحكم CDN، لا في الملف.
3. رمز الحالة
تتعامل Google مع "كل أخطاء 4xx، باستثناء 429، كما لو لم يكن هناك ملف robots.txt صالح"، فالملف المفقود يعني عدم وجود قيود.8 أما 5xx فعكس ذلك: "خلال أول 12 ساعة، تتوقف Google عن زحف الموقع لكنها تستمر في محاولة جلب ملف robots.txt"، ثم تستخدم آخر نسخة سليمة لمدة تصل إلى 30 يومًا.8 وملف robots.txt الذي تنتهي مهلته أو يرد بخطأ خادم بسبب قاعدة في جدار الحماية هو توقف للزحف على مستوى الموقع كله، ويبدو ملفًا عاديًا في متصفحك.
4. كم يستغرق التغيير
تقول Google إنها "تخزّن محتويات ملف robots.txt مؤقتًا لمدة تصل إلى 24 ساعة عمومًا".8 وتقول OpenAI إنه "قد يستغرق الأمر نحو 24 ساعة من تحديث robots.txt في الموقع حتى تتكيف أنظمتنا" في البحث،3 وتقول Perplexity إن التغييرات قد تستغرق "ما يصل إلى 24 ساعة" حتى تنعكس.4 أصلح الملف، ثم انتظر يومًا قبل الحكم على النتيجة.
الخطوة 2: ماذا قررت شبكة CDN نيابةً عنك؟ (3 دقائق)
افتح قسم الروبوتات أو زواحف الذكاء الاصطناعي في لوحة تحكم CDN واقرأ الحالة الحالية لكل فئة. فهنا على الأرجح اتُّخذ قرار من دونك.
Cloudflare
استبدلت Cloudflare مفتاح "Block AI Bots" (حظر روبوتات الذكاء الاصطناعي) ذا النقرة الواحدة بثلاث سياسات: "Search" (البحث: الزحف لبناء فهرس بحث)، و"Training" (التدريب: الزحف لتدريب نموذج أو ضبطه)، و"Agent" (الوكيل: وكلاء يوجههم المستخدم يزورون صفحة نيابةً عن إنسان).1 ومنذ 15 سبتمبر 2026، يُعرض على كل نطاق جديد واحد من إعدادين مسبقين. فالموقع الذي "لا يحقق دخلًا من الإعلانات" يحصل على Search وTraining وAgent كلها مضبوطة على Allow (السماح)؛ والموقع "الذي يحقق دخلًا من الإعلانات" يحصل على Search بقيمة Allow، وTraining بقيمة "Disallow AI Training" (منع التدريب على الذكاء الاصطناعي)، وAgent بقيمة "Block on pages with ads" (الحظر في الصفحات التي تحتوي على إعلانات).1
ونُقل العملاء الحاليون أيضًا. فالنطاق الذي لم يلمس أدوات التحكم التفصيلية قط وكان مفتاح "Block AI Bots" القديم مفعّلًا فيه أصبح الآن على Search Allow، وTraining Disallow AI Training، وAgent Block on pages with ads.1 وهذا خبر سار لكل من فعّل المفتاح في 2025 ثم تساءل لاحقًا لماذا توقف ChatGPT عن الاستشهاد به: فالزحف للبحث مسموح به من جديد. لكن اقرأ صف Search بنفسك، لأن "Block وBlock on pages with ads ينطبقان الآن على الزواحف مختلطة الاستخدام، بما فيها Applebot وBingbot وGooglebot"، لذا "يؤثر أي من الإعدادين في البحث كما في التدريب".1 فضبط Block على Search يخفيك عن Google أيضًا. وللإبقاء على البحث وإيقاف التدريب، الإعداد هو Disallow AI Training: "تحت Disallow AI Training يمكنها الاستمرار في زحف موقعك من أجل البحث".1
Vercel
مجموعة القواعد المُدارة لروبوتات الذكاء الاصطناعي في Vercel "غير نشطة افتراضيًا"، وتظهر بقيمة Allow، وتتيح لك "حظر فئتي AI Crawlers أو AI Assistants كلٍّ على حدة".9 والفئتان محددتان بدقة: "AI Crawlers (زواحف الذكاء الاصطناعي): روبوتات تزحف وتجمع المحتوى للتدريب" و"AI Assistants (مساعدات الذكاء الاصطناعي): روبوتات تجلب الصفحات استجابةً لإجراءات المستخدمين أو تستخدمها لاستعلامات البحث".9 وضبط Deny (الرفض) على AI Assistants "يحظر كل الحركة المحددة على أنها قادمة من روبوتات الذكاء الاصطناعي في تلك الفئة"،9 وهي حركة البحث التي تريدها. أما Deny على AI Crawlers وحدها فهو الانسحاب من التدريب فقط.
شبكات CDN ومزوّدو الاستضافة الآخرون
ينطبق السؤالان نفسهما في كل مكان: هل هناك فئة روبوتات تشمل زواحف البحث أو المساعدات، وما الإجراء المضبوط لها؟ فإذا كانت لوحة التحكم لا تقدم سوى "حظر روبوتات الذكاء الاصطناعي" كمفتاح واحد، فافترض أنه يحظر زواحف البحث أيضًا إلى أن تقول وثائق المزوّد خلاف ذلك.
الخطوة 3: هل يسمح جدار الحماية بمرور الزاحف؟ (3 دقائق)
اجلب صفحتك الرئيسية مرتين: مرة كمتصفح، ومرة بوكيل مستخدم حقيقي لزاحف ذكاء اصطناعي، وقارن رمزي الحالة.
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36" https://yourdomain.com/
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot" https://yourdomain.com/
السلسلة الثانية هي وكيل المستخدم المنشور لـ OAI-SearchBot؛3 كرر العملية بـ PerplexityBot/1.04 وClaudeBot.6 وينبغي أن يرد الطلبان بـ 200. فإذا رد طلب الزاحف بـ 403 أو 401 أو 429، أو بصفحة تحدٍّ، فهناك شيء على الخادم أو في WAF يطابق وكيل المستخدم. وهذا هو الاختبار الذي أجرته HasData على نطاق واسع، والذي كشف فجوة قدرها 30 نقطة بين المتصفحات وGPTBot على مواقع الناشرين.5
و403 هو الأسوأ بين الثلاثة بالنسبة إلى البحث، لأن الزواحف تقرؤه على أنه "المحتوى غير موجود". وGoogle صريحة في ذلك: "لا تستخدم Google المحتوى من عناوين URL التي ترد برموز حالة 4xx"، و"يزيل خط الفهرسة عنوان URL من الفهرس إذا كان مفهرسًا من قبل".10 وتحذر أيضًا: "لا تستخدم رمزي الحالة 401 و403 للحد من معدل الزحف".10 أما 429 أو 5xx فيُقرأ على أنه حمل زائد: فهذه الأخطاء "تدفع زواحف Google إلى إبطاء الزحف مؤقتًا"، وعناوين URL المفهرسة بالفعل "تُحفظ في الفهرس، لكنها تُحذف في النهاية".10 والقاعدة الواسعة التي تطابق كلمة "bot" في أي وكيل مستخدم تفعل هذا بـ Googlebot وBingbot أيضًا.
ثلاثة أماكن تبحث فيها حين يفشل الاختبار:
- WAF أو إضافة الأمان. ابحث في قواعدها عن "user agent" و"bad bots" و"AI bots" و"crawler". فإذا كانت لدى الإضافة قائمة بوكلاء المستخدم التي تحظرها، فافتحها وتحقق مما إذا كان أي زاحف لمحرك بحث بالذكاء الاصطناعي مدرجًا فيها.
- تحديد المعدل. تجلب الزواحف صفحات كثيرة في وقت قصير. فإذا كان الحد يرد بـ
403بدلًا من429، فكل صفحة يصلها تُعامل على أنها اختفت.10 - حظر عناوين IP. تنشر OpenAI وAnthropic وPerplexity نطاقات IP التي تستخدمها زواحفها، فيمكنك التحقق من أن الزاحف حقيقي بدلًا من التخمين من وكيل المستخدم؛364 وتشير Perplexity إلى أن "لكل روبوت نطاقات IP خاصة به، فطابق كل User-Agent مع نطاقات IP الخاصة به".4 استخدم القوائم للسماح، لا كوسيلة للانسحاب: فتحذر Anthropic من أن حظر عناوين IP الخاصة بها "قد لا يعمل بشكل صحيح أو يضمن الانسحاب بشكل دائم، لأنه يعيق قدرتنا على قراءة ملف robots.txt لديك".6
ما الذي ينبغي أن تسمح به وما الذي ينبغي أن تحظره؟
قرر بحسب الغرض، لا بحسب الشركة. فزواحف البحث والمستخدمين هي التي تجعلك تُستشهد بك؛ أما التدريب فمسألة منفصلة لها مفتاح منفصل لدى كل مزوّد.3647
| الهدف | robots.txt | CDN | جدار الحماية |
|---|---|---|---|
| أن تستشهد بك مساعدات الذكاء الاصطناعي مع الإبقاء على Google | اسمح لـ OAI-SearchBot وClaude-SearchBot وPerplexityBot وGooglebot | فئة Search أو Assistants مضبوطة على Allow | لا توجد قاعدة لوكيل المستخدم أو للمعدل ترد عليها بـ 403 |
| الإبقاء على ذلك، مع الانسحاب من تدريب النماذج | أضف Disallow: / لـ GPTBot وClaudeBot وGoogle-Extended | Training مضبوط على Disallow AI Training (في Cloudflare) أو Deny على AI Crawlers (في Vercel) | لا شيء إضافي |
| البقاء خارج إجابات الذكاء الاصطناعي تمامًا | امنع زواحف البحث أيضًا | احظر فئة Search أو Assistants | اختياري، للزواحف التي تتجاهل robots.txt |
الصف الثالث وحده يكلّفك الظهور في محركات البحث بالذكاء الاصطناعي. أما الصف الثاني فبلا ثمن: تقول Google إن Google-Extended "لا يُستخدم كإشارة ترتيب في بحث Google"،7 وتقول OpenAI إن الموقع يمكنه "السماح لـ OAI-SearchBot من أجل الظهور في نتائج البحث مع منع GPTBot".3
كيف تساعد ContentMas في مسألة حظر زواحف الذكاء الاصطناعي؟
ContentMas أداة SEO مدعومة بالذكاء الاصطناعي تدقّق موقعك لـ Google ومحركات البحث بالذكاء الاصطناعي، وتبيّن لك بدقة ما يجب إصلاحه لتتقدّم في الترتيب ويُستشهد بموقعك. وتنظر فحوص الجاهزية التقنية لديها فيما إذا كانت الزواحف تستطيع الوصول إلى كل صفحة وقراءتها: قواعد robots.txt التي تنطبق على زواحف البحث والذكاء الاصطناعي، ورمز الحالة الذي يرد به الملف والصفحات، وعمليات إعادة التوجيه، ومقدار المحتوى الموجود في HTML الذي يرسله الخادم. وتتحقق ركيزة الجاهزية لـ SEO وGEO (الظهور في Google ومحركات البحث بالذكاء الاصطناعي؛ وGEO تعني Generative Engine Optimization) من إمكانية العثور على الصفحات التي تجتاز الفحص واقتباسها.
تأتي كل نتيجة مع دليلها وإصلاحها، مرتبة بحسب الأثر، عبر ست ركائز وأكثر من 600 مؤشر أداء (KPI). وتقرأ الخطة المجانية ما يصل إلى 10 صفحات في كل عملية فحص، بواقع 3 عمليات فحص كل 24 ساعة. اطلع على كيف نحسب الدرجة أو شغّل تدقيقًا.
أهم النقاط
- يمكن للموقع أن يحظر زواحف الذكاء الاصطناعي في robots.txt وفي إعدادات الروبوتات في CDN وفي جدار الحماية؛ فـ robots.txt إرشادي، والآخران مفروضان، والثلاثة تحتاج إلى فحص.345
- زواحف التدريب والبحث والمستخدمين وكلاء مستخدم منفصلون بمفاتيح منفصلة لدى OpenAI وAnthropic وPerplexity؛ وGoogle-Extended رمز في robots.txt بلا وكيل مستخدم، ولا يؤثر أبدًا في بحث Google.3647
- وجدت HasData أن 39.5% من المواقع التي تمنع GPTBot لا تزال تقدم له الصفحات، وأن الناشرين يردون على وكيل مستخدم GPTBot بنسبة أقل بـ 30 نقطة مما يردون على المتصفح: فالملف والخادم يختلفان في الاتجاهين.5
- تقسّم Cloudflare الآن حركة الذكاء الاصطناعي إلى Search وTraining وAgent، ونقلت نطاقات "Block AI Bots" القديمة إلى Search Allow، وتحذر من أن ضبط Block على Search يحظر Googlebot وBingbot أيضًا.1
- رمز
403من جدار الحماية يخبر Google بأن الصفحة غير موجودة ويزيلها من الفهرس؛ أما429فيبطئ الزحف فقط.10 اختبر بوكيل مستخدم حقيقي لزاحف وتوقع200.3
عشر دقائق تكفي لمعرفة ما إذا كانت المشكلة في محتواك أم في بواباتك. افتح الملف، وافتح لوحة التحكم، وشغّل طلبين. فإذا سمحت الطبقات الثلاث كلها بمرور زواحف البحث، فما يتبقى مسألة محتوى.
اقرأ أيضًا: هل تستطيع زواحف الذكاء الاصطناعي قراءة موقعك؟ فحص تقني في 10 دقائق وكيف يؤثر أمان الموقع في ترتيبه في البحث وثقة العملاء
أدلة الركائز الست: الجاهزية التقنية · جودة المحتوى · الثقة · الحداثة · الأمان · SEO وGEO · كيف تحسب ContentMas درجة كل ركيزة
الأسئلة الشائعة
هل يُبقي حظر GPTBot موقعي خارج بحث ChatGPT؟
لا. فتستخدم OpenAI روبوت GPTBot للتدريب وOAI-SearchBot للبحث، وتقول إن "كل إعداد مستقل عن الإعدادات الأخرى".3 والمواقع التي تنسحب من OAI-SearchBot وحدها هي التي "لن تظهر في إجابات بحث ChatGPT"، وإن كان يمكنها "أن تظهر مع ذلك كروابط تنقّل".3
هل يزيل حظر Google-Extended صفحاتي من AI Overviews؟
لا. فتقول Google إن Google-Extended "لا يؤثر في إدراج الموقع في بحث Google ولا يُستخدم كإشارة ترتيب"، وإنه يتحكم فقط فيما إذا كان المحتوى المزحوف يُستخدم لتدريب نماذج Gemini وتأسيس إجاباتها.7 وأداة التحكم في AI Overviews وAI Mode هي قاعدة robots.txt الخاصة بـ Googlebot، وتطلب Google أن يكون الزحف مسموحًا به "من قِبل أي CDN أو بنية استضافة" أيضًا.2
فعّلت خيار "Block AI Bots" في Cloudflare في 2025. هل لا يزال يحظر زواحف البحث؟
على الأرجح لا. فقد نقلت Cloudflare النطاقات التي لم تستخدم أدوات التحكم التفصيلية قط إلى Search Allow، وTraining "Disallow AI Training"، وAgent "Block on pages with ads".1 افتح سياسة Search وتأكد من أنها على Allow، لأن ضبط Block هناك ينطبق الآن على Googlebot وBingbot وApplebot أيضًا.1
كم يستغرق الزاحف ليلاحظ التغيير بعد تعديل robots.txt؟
نحو يوم. فتخزّن Google ملف robots.txt مؤقتًا "لمدة تصل إلى 24 ساعة"،8 وتقول OpenAI إن أنظمة البحث لديها تستغرق "نحو 24 ساعة" لتتكيف،3 وتقول Perplexity إن التغييرات قد تستغرق "ما يصل إلى 24 ساعة".4 أما تغيير جدار الحماية فيسري مع الطلب التالي.
هل يستطيع جدار الحماية حظر زواحف الذكاء الاصطناعي التي تتجاهل robots.txt؟
نعم، وهو الأداة المناسبة للجالبات التي يشغّلها المستخدم مثل ChatGPT-User وPerplexity-User، التي تقول وثائقها نفسها إن قواعد robots.txt قد لا تنطبق عليها.34 طابقها بوكيل المستخدم وبنطاقات IP التي ينشرها المزوّدون،34 ولا ترد بـ 403 إلا على الزواحف التي تقصد رفضها، وليس على زواحف البحث أبدًا.10
المراجع
كل رقم في المقال يحيل إلى مصدره أدناه.
-
Cloudflare — Have it both ways: stay discoverable in search while disallowing AI training (يُفتح في علامة تبويب جديدة)، سبتمبر 2026. ↩
-
Google Search Central — AI features and your website (يُفتح في علامة تبويب جديدة)، ديسمبر 2025. ↩
-
OpenAI — Overview of OpenAI Crawlers (يُفتح في علامة تبويب جديدة)، اطُّلع عليه في نوفمبر 2026. ↩
-
Perplexity — Perplexity Crawlers (يُفتح في علامة تبويب جديدة)، اطُّلع عليه في نوفمبر 2026. ↩
-
HasData — The AI Crawler Block Index (يُفتح في علامة تبويب جديدة)، أكتوبر 2026. ↩
-
Anthropic — Does Anthropic crawl data from the web, and how can site owners block the crawler? (يُفتح في علامة تبويب جديدة)، أكتوبر 2026. ↩
-
Google Search Central — Google's common crawlers (يُفتح في علامة تبويب جديدة)، أكتوبر 2026. ↩
-
Google Search Central — How Google interprets the robots.txt specification (يُفتح في علامة تبويب جديدة)، أكتوبر 2026. ↩
-
Vercel — WAF Managed Rulesets (يُفتح في علامة تبويب جديدة)، سبتمبر 2026. ↩
-
Google Search Central — How HTTP status codes affect Google's crawlers (يُفتح في علامة تبويب جديدة)، فبراير 2026. ↩
عن هذا المقال
كتبه Nasir Ali Joiya، الرئيس التنفيذي والمؤسس المشارك لشركة ZAPTA Technologies. راجعه فريق ContentMas الذي يطوّر ContentMas، وهي أداة تدقيق SEO مدعومة بالذكاء الاصطناعي تفحص المواقع وفق ست ركائز لـ Google ومحركات البحث بالذكاء الاصطناعي. ترتبط الحقائق والأرقام بمصادرها الأصلية في قسم المراجع. هل لاحظت معلومة قديمة؟ راسلنا وسنصححها.
تدقيق مجاني للموقع
اعرف درجة موقعك لدى محركات البحث ومساعدي الذكاء الاصطناعي.
درجة واحدة، ودرجات الركائز الست، وقائمة إصلاحات مرتبة خلال دقائق. دون بطاقة ائتمان.
ابدأ التدقيق المجاني